Context Engineering
Por que o gargalo mudou da geração para o contexto
Em 2026, a maior parte das discussões sobre agentes de código ainda gira em torno do modelo: qual é o melhor, qual tem a janela de contexto maior, qual gera código mais rápido.
Há, no entanto, um consenso crescente na literatura e na prática de engenharia: o gargalo principal deixou de ser a capacidade de geração. Passou a ser o contexto.
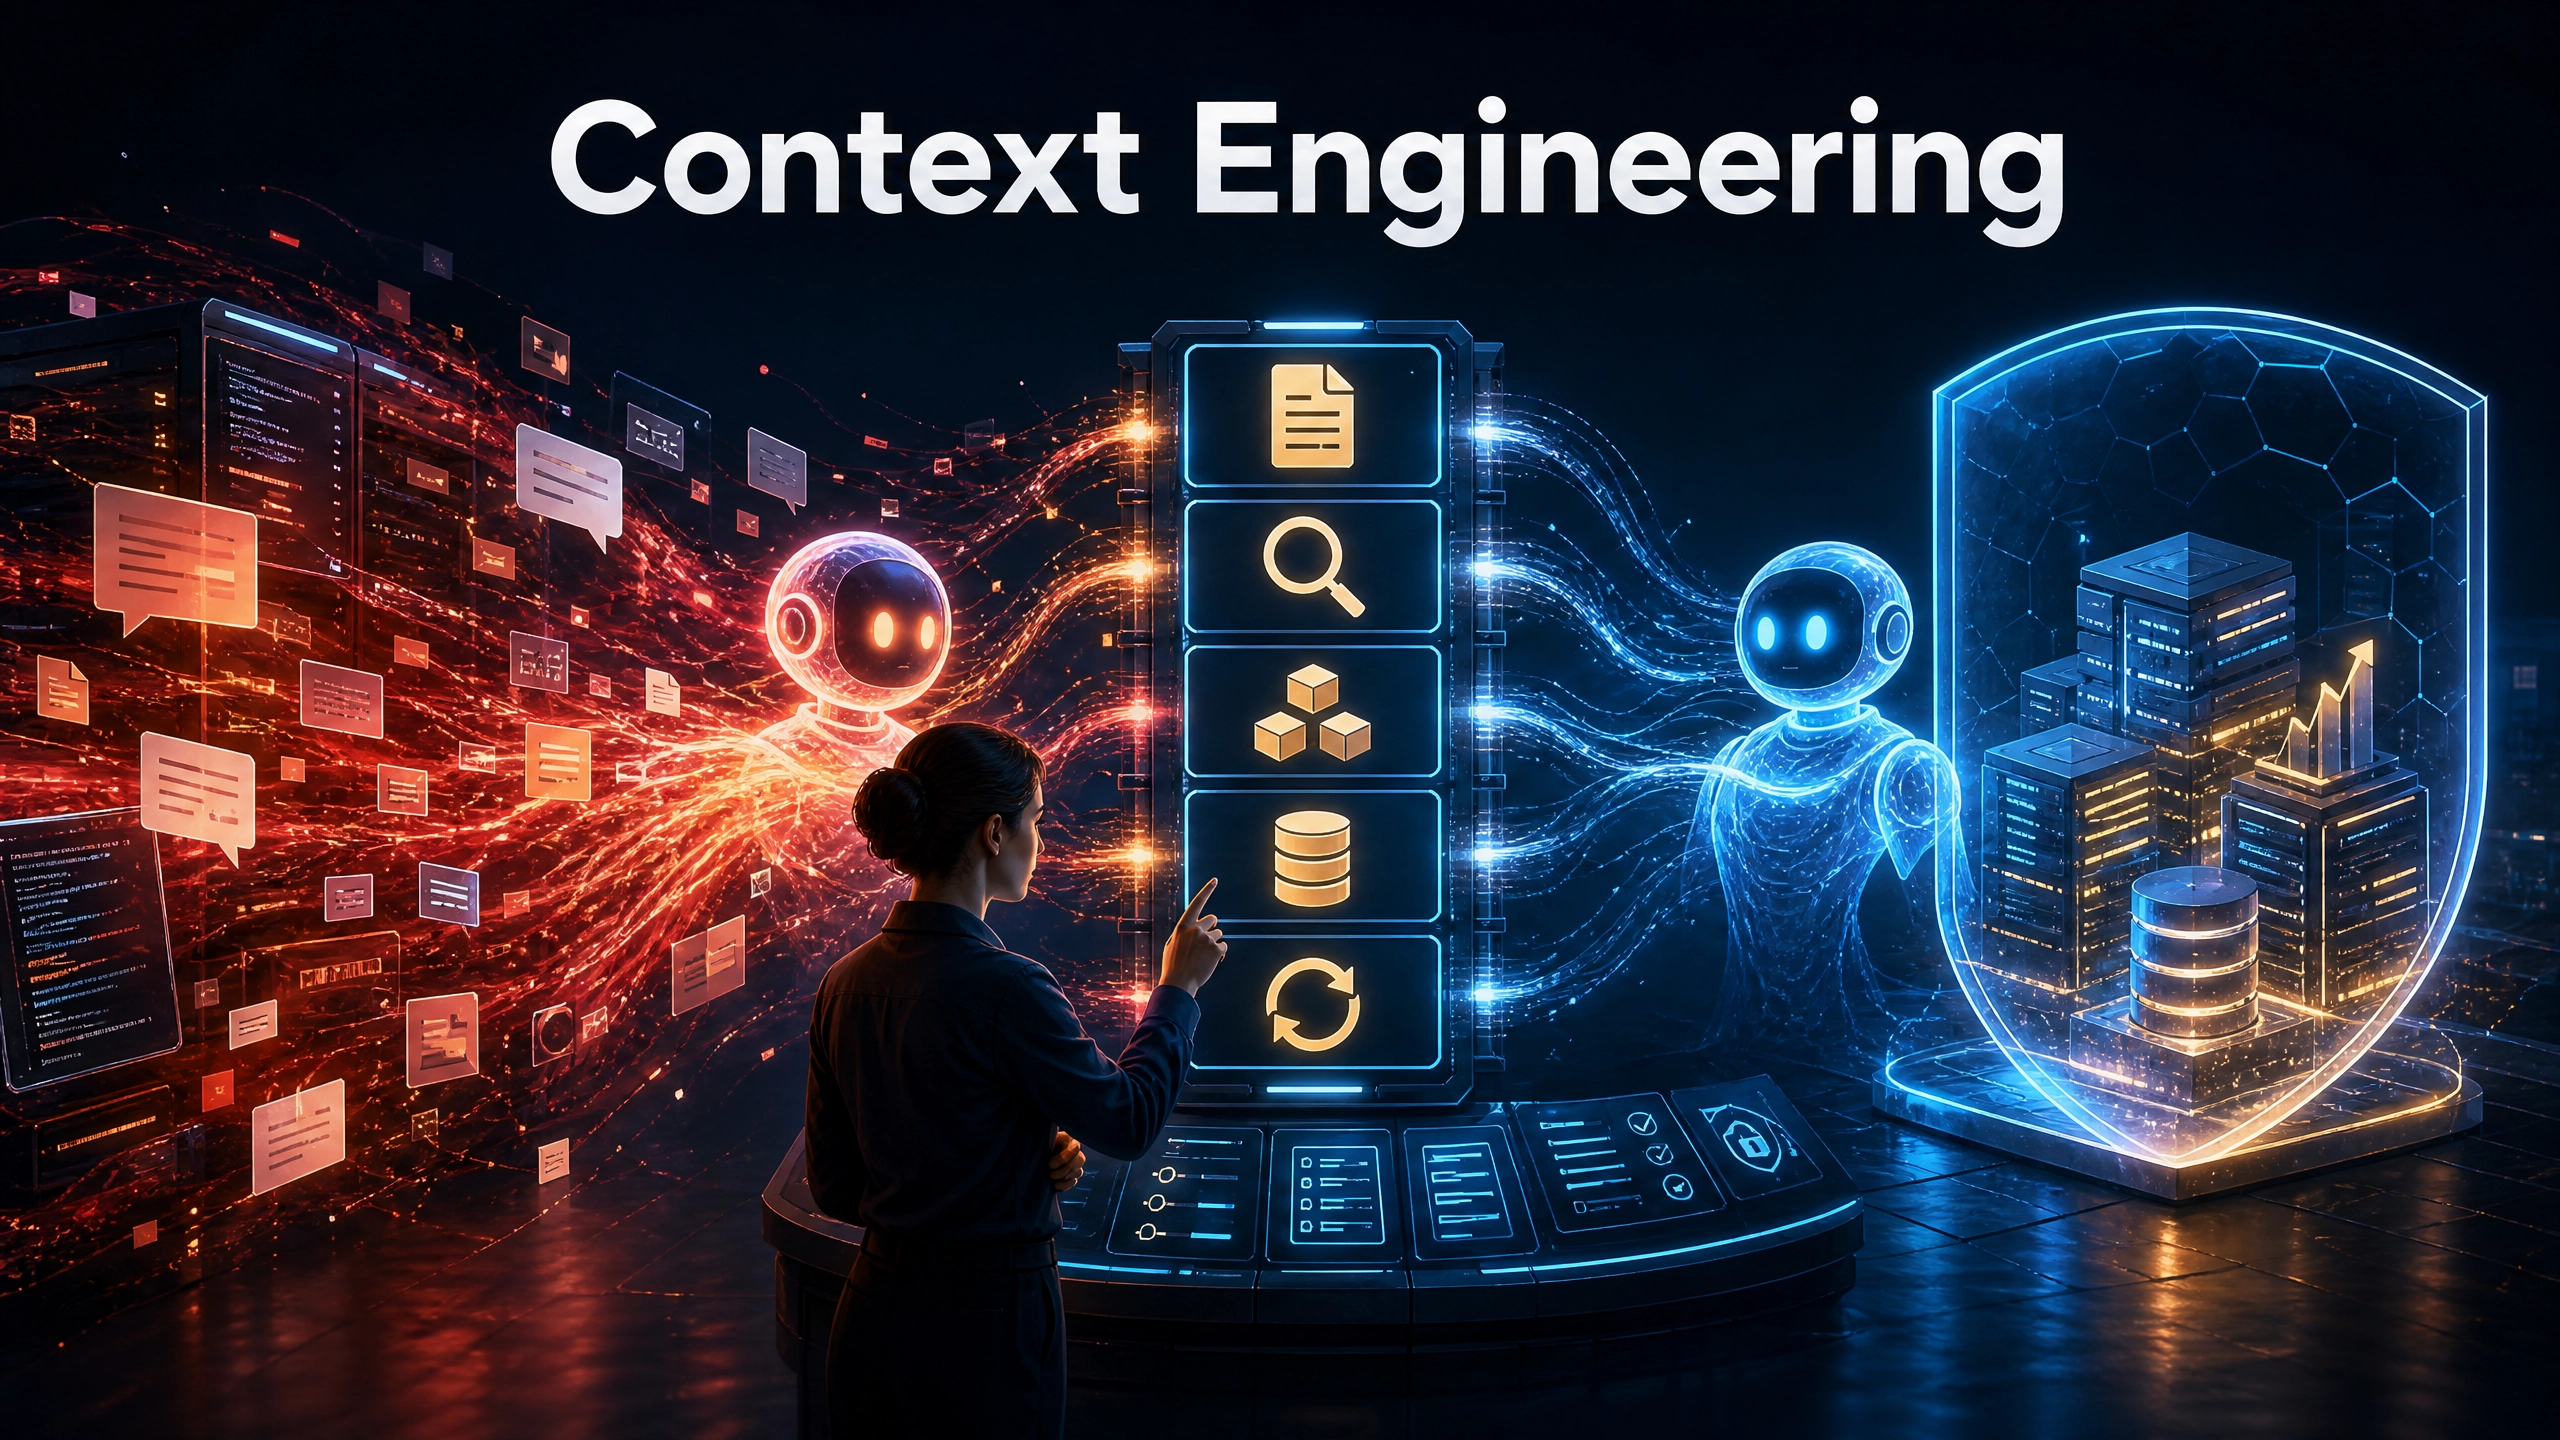
Context Engineering é a disciplina de decidir, de forma deliberada, o que o agente vê em cada momento — e o que ele não vê. Não se trata apenas de escrever um prompt melhor. Trata-se de projetar a informação que entra na janela de contexto, o que permanece entre sessões e o que é recuperado sob demanda.
Por que contexto se tornou o ponto crítico
Agentes de código operam com uma janela de contexto finita. Nela entram, ao mesmo tempo:
- Instruções de sistema e regras do projeto
- Arquivos lidos
- Histórico da conversa
- Saídas de ferramentas
- Resultados de testes e logs
Quando esse conjunto fica desorganizado ou excessivo, o desempenho cai. Estudos recentes descrevem efeitos conhecidos: degradação de atenção em contextos longos, dificuldade de recuperar informação do meio da janela e tendência a repetir padrões anteriores mesmo quando eles já não se aplicam.
Em repositórios grandes, o problema se agrava. O agente precisa de informação estrutural (dependências, convenções, decisões históricas), não apenas de trechos de código semelhantes ao pedido atual. Sem essa camada, ele tende a produzir soluções localmente corretas e globalmente inconsistentes.
O que as equipes estão colocando nos arquivos de contexto
Uma prática que se consolidou é o uso de arquivos persistentes de instrução — AGENTS.md, CLAUDE.md e equivalentes. Um estudo empírico de 2026 analisou mais de 2.300 desses arquivos em quase 2.000 repositórios.
Os resultados mostram priorização clara:
- Procedimentos de teste: presentes em 50% dos arquivos
- Detalhes de implementação: presentes em 41% dos arquivos
- Arquitetura e estrutura do projeto: presentes em 35% dos arquivos
Em contraste, requisitos não funcionais como segurança e desempenho aparecem com bem menos frequência. Isso indica que muitas equipes ainda tratam o arquivo de contexto como documentação operacional, e não como instrumento de governança.
Outro dado relevante: apenas 16% dos arquivos analisados mencionam o Model Context Protocol (MCP), indicando que a maioria das equipes ainda não adotou mecanismos padronizados de acesso a ferramentas e dados.
Camadas práticas de Context Engineering
A literatura e a prática de 2026 apontam algumas camadas recorrentes:
- Instruções persistentes do projeto: Arquivos lidos no início de cada sessão. Devem ser concisos e orientados a decisões ("use TypeScript strict", "não altere contratos públicos sem revisão"), e não listas exaustivas de práticas.
- Contexto recuperado sob demanda: Em vez de carregar o repositório inteiro, o agente busca trechos relevantes. Abordagens baseadas em análise estática (dependências estruturais) tendem a ser mais estáveis em tarefas de nível de função. Abordagens de navegação dinâmica ganham valor em tarefas mais complexas, mas dependem de modelos mais capazes e consomem mais recursos.
- Skills e módulos carregáveis: Instruções e recursos que o agente só carrega quando julga necessários, reduzindo o ruído na janela de contexto.
- Memória e estado entre sessões: Mecanismos para preservar decisões, convenções e erros já conhecidos, evitando que cada sessão recomece do zero.
- O próprio ciclo de desenvolvimento (SDLC) como contexto: O modo como o trabalho é especificado, revisado, testado e liberado é a camada de contexto mais importante. Arquivos de instrução ajudam, mas não substituem regras operacionais claras sobre quando escalar para um humano, que tipo de teste se aplica a cada tipo de mudança e o que constitui evidência de aceite.
Problemas recorrentes quando o contexto é mal gerido
Vários trabalhos recentes descrevem padrões de falha:
- Explosão de contexto: A janela se enche com histórico e saídas de ferramentas, degradando a qualidade.
- Deriva silenciosa entre especificação e código: O código evolui, a especificação não, e a divergência só aparece tarde.
- Contexto contaminado: Erros anteriores permanecem na janela e influenciam decisões seguintes.
- Excesso de informação irrelevante: O agente se distrai com material que não contribui para a tarefa atual.
A resposta comum a esses problemas não é "aumentar a janela". É curadoria: o que deve estar sempre presente, o que deve ser recuperado sob demanda e o que deve ser descartado.
O que Fazer vs. O que Não Fazer com Context Engineering
🚫 O que NÃO Fazer
Não trate contexto como "mais um prompt"
- Exemplo do que não fazer: Criar um prompt longo e acreditar que "mais informação é sempre melhor".
- O que acontece na prática: Explosão de contexto. A janela se enche com histórico e saídas de ferramentas, degradando a qualidade.
- Alternativa correta: Contexto é curadoria. Decida o que deve estar sempre presente, o que deve ser recuperado sob demanda e o que deve ser descartado.
Não ignore requisitos não funcionais no contexto
- Exemplo do que não fazer: Ter um
AGENTS.mdque só fala de testes e implementação, sem mencionar segurança, performance ou observabilidade. - O que acontece na prática: O agente ignora segurança. Vulnerabilidades são geradas em escala.
- Alternativa correta: Inclua requisitos não funcionais explicitamente no contexto. Eles são instrumento de governança, não detalhe operacional.
- Exemplo do que não fazer: Ter um
Não deixe o contexto desatualizado
- Exemplo do que não fazer: Criar um
AGENTS.mdno início do projeto e nunca mais revisitar. - O que acontece na prática: Deriva silenciosa entre especificação e código. A divergência só aparece tarde.
- Alternativa correta: Trate arquivos de contexto como artefatos vivos, não como documentação esquecida.
- Exemplo do que não fazer: Criar um
✅ O que FAZER
Crie um arquivo de contexto persistente
- Exemplo do que fazer: Crie um
AGENTS.mdouCLAUDE.mdno repositório com padrões de código, regras de teste, convenções do projeto e requisitos não funcionais (segurança, performance, observabilidade). - Resultado prático: Consistência entre execuções, menos repetição e governança ativa.
- Exemplo do que fazer: Crie um
Use contexto recuperado sob demanda
- Exemplo do que fazer: Em vez de carregar o repositório inteiro, use análise estática para buscar trechos relevantes.
- Resultado prático: Janela de contexto mais limpa e melhor desempenho do agente.
Preserve memória entre sessões
- Exemplo do que fazer: Adote mecanismos para preservar decisões, convenções e erros já conhecidos.
- Resultado prático: Cada sessão não recomeça do zero, gerando aprendizado acumulado.
Faça do SDLC o contexto principal
- Exemplo do que fazer: Defina regras operacionais claras: quando escalar para um humano, que tipo de teste se aplica a cada tipo de mudança e o que constitui evidência de aceite.
- Resultado prático: O agente opera com menos ambiguidade, reduzindo retrabalho.
Audite o contexto periodicamente
- Exemplo do que fazer: Revise arquivos de contexto a cada sprint ou a cada mudança significativa no projeto.
- Resultado prático: Contexto atualizado = agente atualizado = qualidade consistente.
Implicações para CTOs e líderes técnicos
Para quem lidera times de engenharia, Context Engineering deixa de ser detalhe de ferramenta e passa a ser decisão de processo.
Algumas perguntas práticas:
- Existe um conjunto mínimo e versionado de instruções de projeto que todos os agentes leem?
- Requisitos não funcionais (segurança, desempenho, observabilidade) estão explícitos nesse conjunto?
- Há distinção clara entre o que o agente pode decidir sozinho e o que exige revisão humana?
- O time trata arquivos de contexto como artefatos vivos, ou como documentação esquecida?
- A estrutura de trabalho (especificações, revisão, testes, critérios de aceite) está legível o suficiente para um agente operar com menos ambiguidade?
Times que investem apenas em escolher o "melhor" agente e negligenciam o contexto tendem a acelerar a geração de código e, ao mesmo tempo, aumentar o retrabalho.
Conclusão
Context Engineering não é uma técnica de prompt. É a prática de tratar a informação que o agente recebe como um ativo de engenharia: versionado, curado, mensurável e alinhado aos objetivos do sistema.
"Em 2026, a capacidade de gerar código deixou de ser o diferencial principal. O diferencial passou a ser a capacidade de controlar o que o agente sabe, o que ele assume e sob quais restrições ele opera."
Quem continua tratando contexto como "mais um prompt" está, na prática, deixando um dos principais fatores de qualidade e risco fora do processo formal de engenharia.
📚 Fontes da Pesquisa
- Estudo empírico sobre arquivos de contexto de agentes (2026)
Análise de mais de 2.300 arquivosAGENTS.md/CLAUDE.mdem quase 2.000 repositórios. Priorização: procedimentos de teste (50%), detalhes de implementação (41%), arquitetura (35%). Apenas 16% mencionam MCP. - Trabalhos sobre paradigmas de recuperação de contexto
Análise estática vs. navegação dinâmica em tarefas de nível de função vs. tarefas complexas. - Análises de falhas de contexto em agentes de código
Padrões de falha: explosão de contexto, deriva silenciosa, contexto contaminado, excesso de informação irrelevante. - Práticas documentadas por times e plataformas
Incluindo Sourcegraph, Claude Code e frameworks de memória de agentes. - Papers recentes sobre gestão de working memory
Infraestrutura de contexto codificado em repositórios complexos.
📖 Leituras Recomendadas
Quem quiser aprofundar o tema de forma estruturada — do contexto à governança de agentes — pode consultar a série Engenharia de Software Assistida por IA, em especial o Volume VIII – Engenharia de Contexto e Governança de IA.
💡 Destaques:
- 🏷️ Cupom de 30% OFF nos eBooks:
LEIA30 - 📖 Disponível também no Kindle Unlimited!
👉 Série eBook completa:
📖 Livros Físicos (capa comum):
- 📘 Volume I – A Nova Realidade da Engenharia de Software
- 📙 Volume II – Fundamentos que a IA Não Substitui
- 📗 Volume III – Engenharia de Requisitos na Era da IA
- 📕 Volume IV – Arquitetura e Design de Soluções na Era da IA
- 📓 Volume V – Delegação Técnica para IA
- 📔 Volume VI – Supervisão e Auditoria de Código Gerado por IA
- 📒 Volume VII – Aplicações Reais
- 📗 Volume VIII – Engenharia de Contexto e Governança de IA
🔗 Página do autor na Amazon:
#ContextEngineering #EngenhariaDeSoftware #InteligenciaArtificial #AgentesDeIA #GovernancaIA #Arquitetura #AGENTSmd #CLAUDEmd #FuturoDaEngenharia #MCP