O contexto também envelhece
Por que agentes de código precisam esquecer para continuar corretos
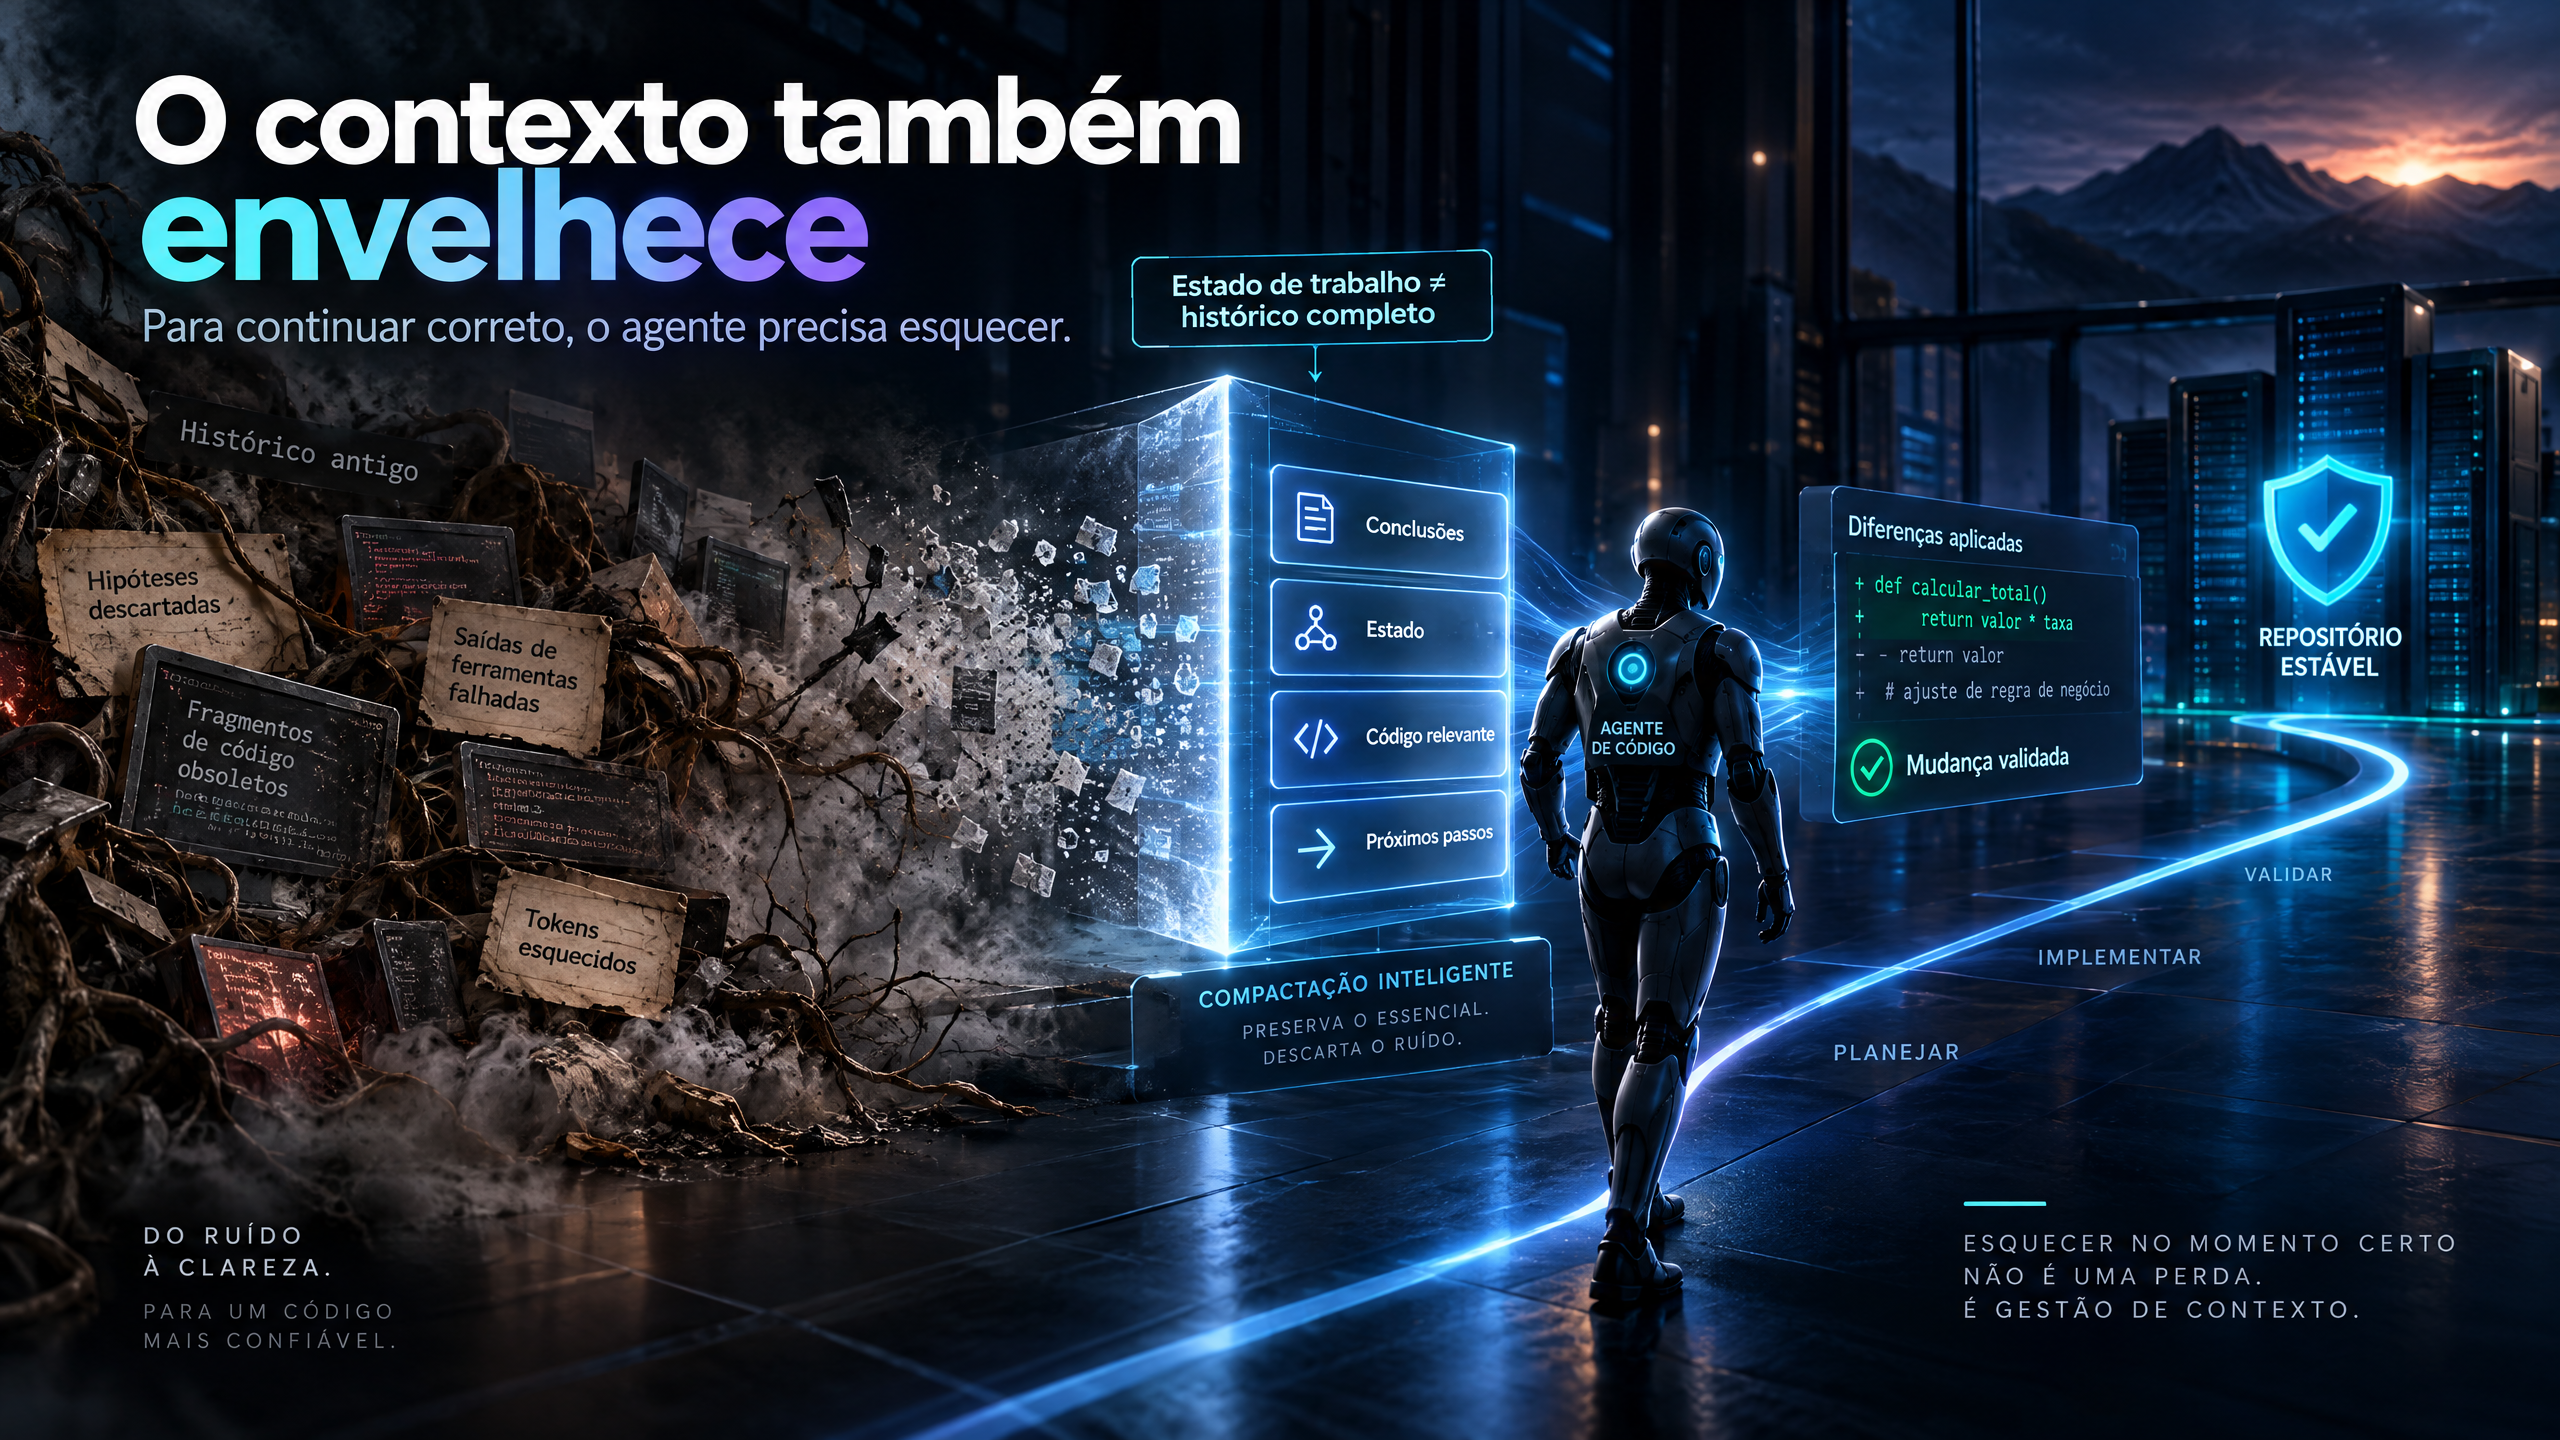
Em tarefas longas de repositório, o agente inspeciona arquivos, busca referências, edita, roda testes e volta a inspecionar. Cada passo deixa rastros no contexto. Parte desse material ainda importa na etapa seguinte; outra parte já virou lixo — hipótese descartada, saída de ferramenta que não se aplicou, tentativa que falhou. Quando o sistema trata todo o histórico como sagrado, o modelo continua raciocinando em cima de coisas que deixaram de ser verdadeiras.
O paper AutoCompact (arXiv:2610.02163, 1º de outubro de 2026) parte dessa observação e muda a pergunta. Em vez de comprimir só quando a janela estoura, o agente aprende a decidir quando compactar, o que preservar como estado de trabalho e como seguir a partir desse resumo. Nos experimentos em SWE-bench Verified e SWE-PolyBench Verified, o ganho absoluto de taxa de sucesso chegou a 9,2 e 5,0 pontos percentuais sobre o modelo base — inclusive com janela de 256K que nunca estoura e com janela curta de 16K em que a compactação de fallback entra quando necessário.
A diferença prática é sutil e cara. Compactação por limite de tokens é reação a estouro. Compactação por estado de tarefa é reconhecimento de que uma fase acabou: a causa raiz foi localizada, certos caminhos foram eliminados, o próximo passo é editar e verificar. O resumo útil guarda conclusões confirmadas, trechos de código relevantes, status do workspace e a lista do que ainda falta. O que sobra de exploração barulhenta some. Se o resumo for ruim, o agente perde o fio — goal loss, regressão de raciocínio, correção aplicada no lugar errado.
O mecanismo que faz isso funcionar
A abordagem do AutoCompact tem duas etapas distintas. Na primeira, o agente base roda tarefas de código e um juiz revisa cada decisão de compactação: o momento escolhido, o resumo escrito e as ações executadas depois da compactação. Outputs defeituosos são substituídos por versões corrigidas antes de serem executados no ambiente, de modo que cada trajetória continue a partir de decisões corrigidas. Na segunda etapa, essas trajetórias corrigidas alimentam um ajuste fino supervisionado, seguido de aprendizado por reforço que otimiza codificação e compactação de forma conjunta, usando recompensa de sucesso na tarefa.
A inovação que a revisão de pré-publicação destaca é justamente essa: o que o agente faz depois da compactação é o elo que faltava nas abordagens anteriores. Não basta decidir quando compactar ou o que escrever no resumo. O agente precisa saber como retomar o trabalho a partir do estado resumido.
Por que a compactação por limite de tokens falha
A crítica à compactação reativa aparece em vários trabalhos recentes. A revisão técnica do paper CliffCompaction (arXiv:2609.26779) explica o problema de custo: qualquer modificação no contexto invalida o cache KV e exige re-prefill do novo contexto a partir do prefixo comum. Tokens de input não cacheados que exigem re-prefill são 5 a 6 vezes mais caros que os cacheados nos modelos estudados. Compactar com frequência, portanto, sai caro.
A estratégia do AutoCompact contorna isso porque a compactação acontece em marcos de tarefa, não a cada estouro de janela. O paper Slipstream (arXiv:2605.08580) segue lógica semelhante ao rodar a compactação de forma assíncrona, enquanto o agente continua executando os próximos passos. A validação por trajetória melhora os resultados em SWE-bench Verified entre 2,6% e 8,8%, indicando que a verificação baseada no que o agente realmente fez é especialmente útil para preservar intenção de patch, interpretação de teste e observações de repositório.
O que a pesquisa sobre context rot já sabia
A degradação por acúmulo de contexto não é uma descoberta nova. O estudo Context Rot da Chroma testou 18 modelos de fronteira e encontrou que a performance não cai de forma gradual: o modelo mantém precisão quase perfeita até certo comprimento de contexto, depois despenca abruptamente. O ponto de queda varia por modelo e tarefa, e não é previsível. A explicação é que cada token adicionado consome orçamento de atenção limitado. Informação irrelevante afoga o que importa em regiões de baixa atenção.
O trabalho sobre Deep Agentic Search (arXiv:2608.01507) detalha o mecanismo: a precisão do modelo cai conforme a proporção de tokens irrelevantes em relação aos relevantes aumenta. O efeito é descrito como context pollution ou context rot, no qual conteúdo distrativo expulsa o sinal que o modelo precisa.
A implicação prática é que "janela grande" não é o mesmo que "contexto útil". Um modelo pode passar em benchmarks de agulha no palheiro com janelas de milhões de tokens, mas falhar ao sintetizar informação espalhada por centenas de páginas.
O que isso muda no desenho do harness
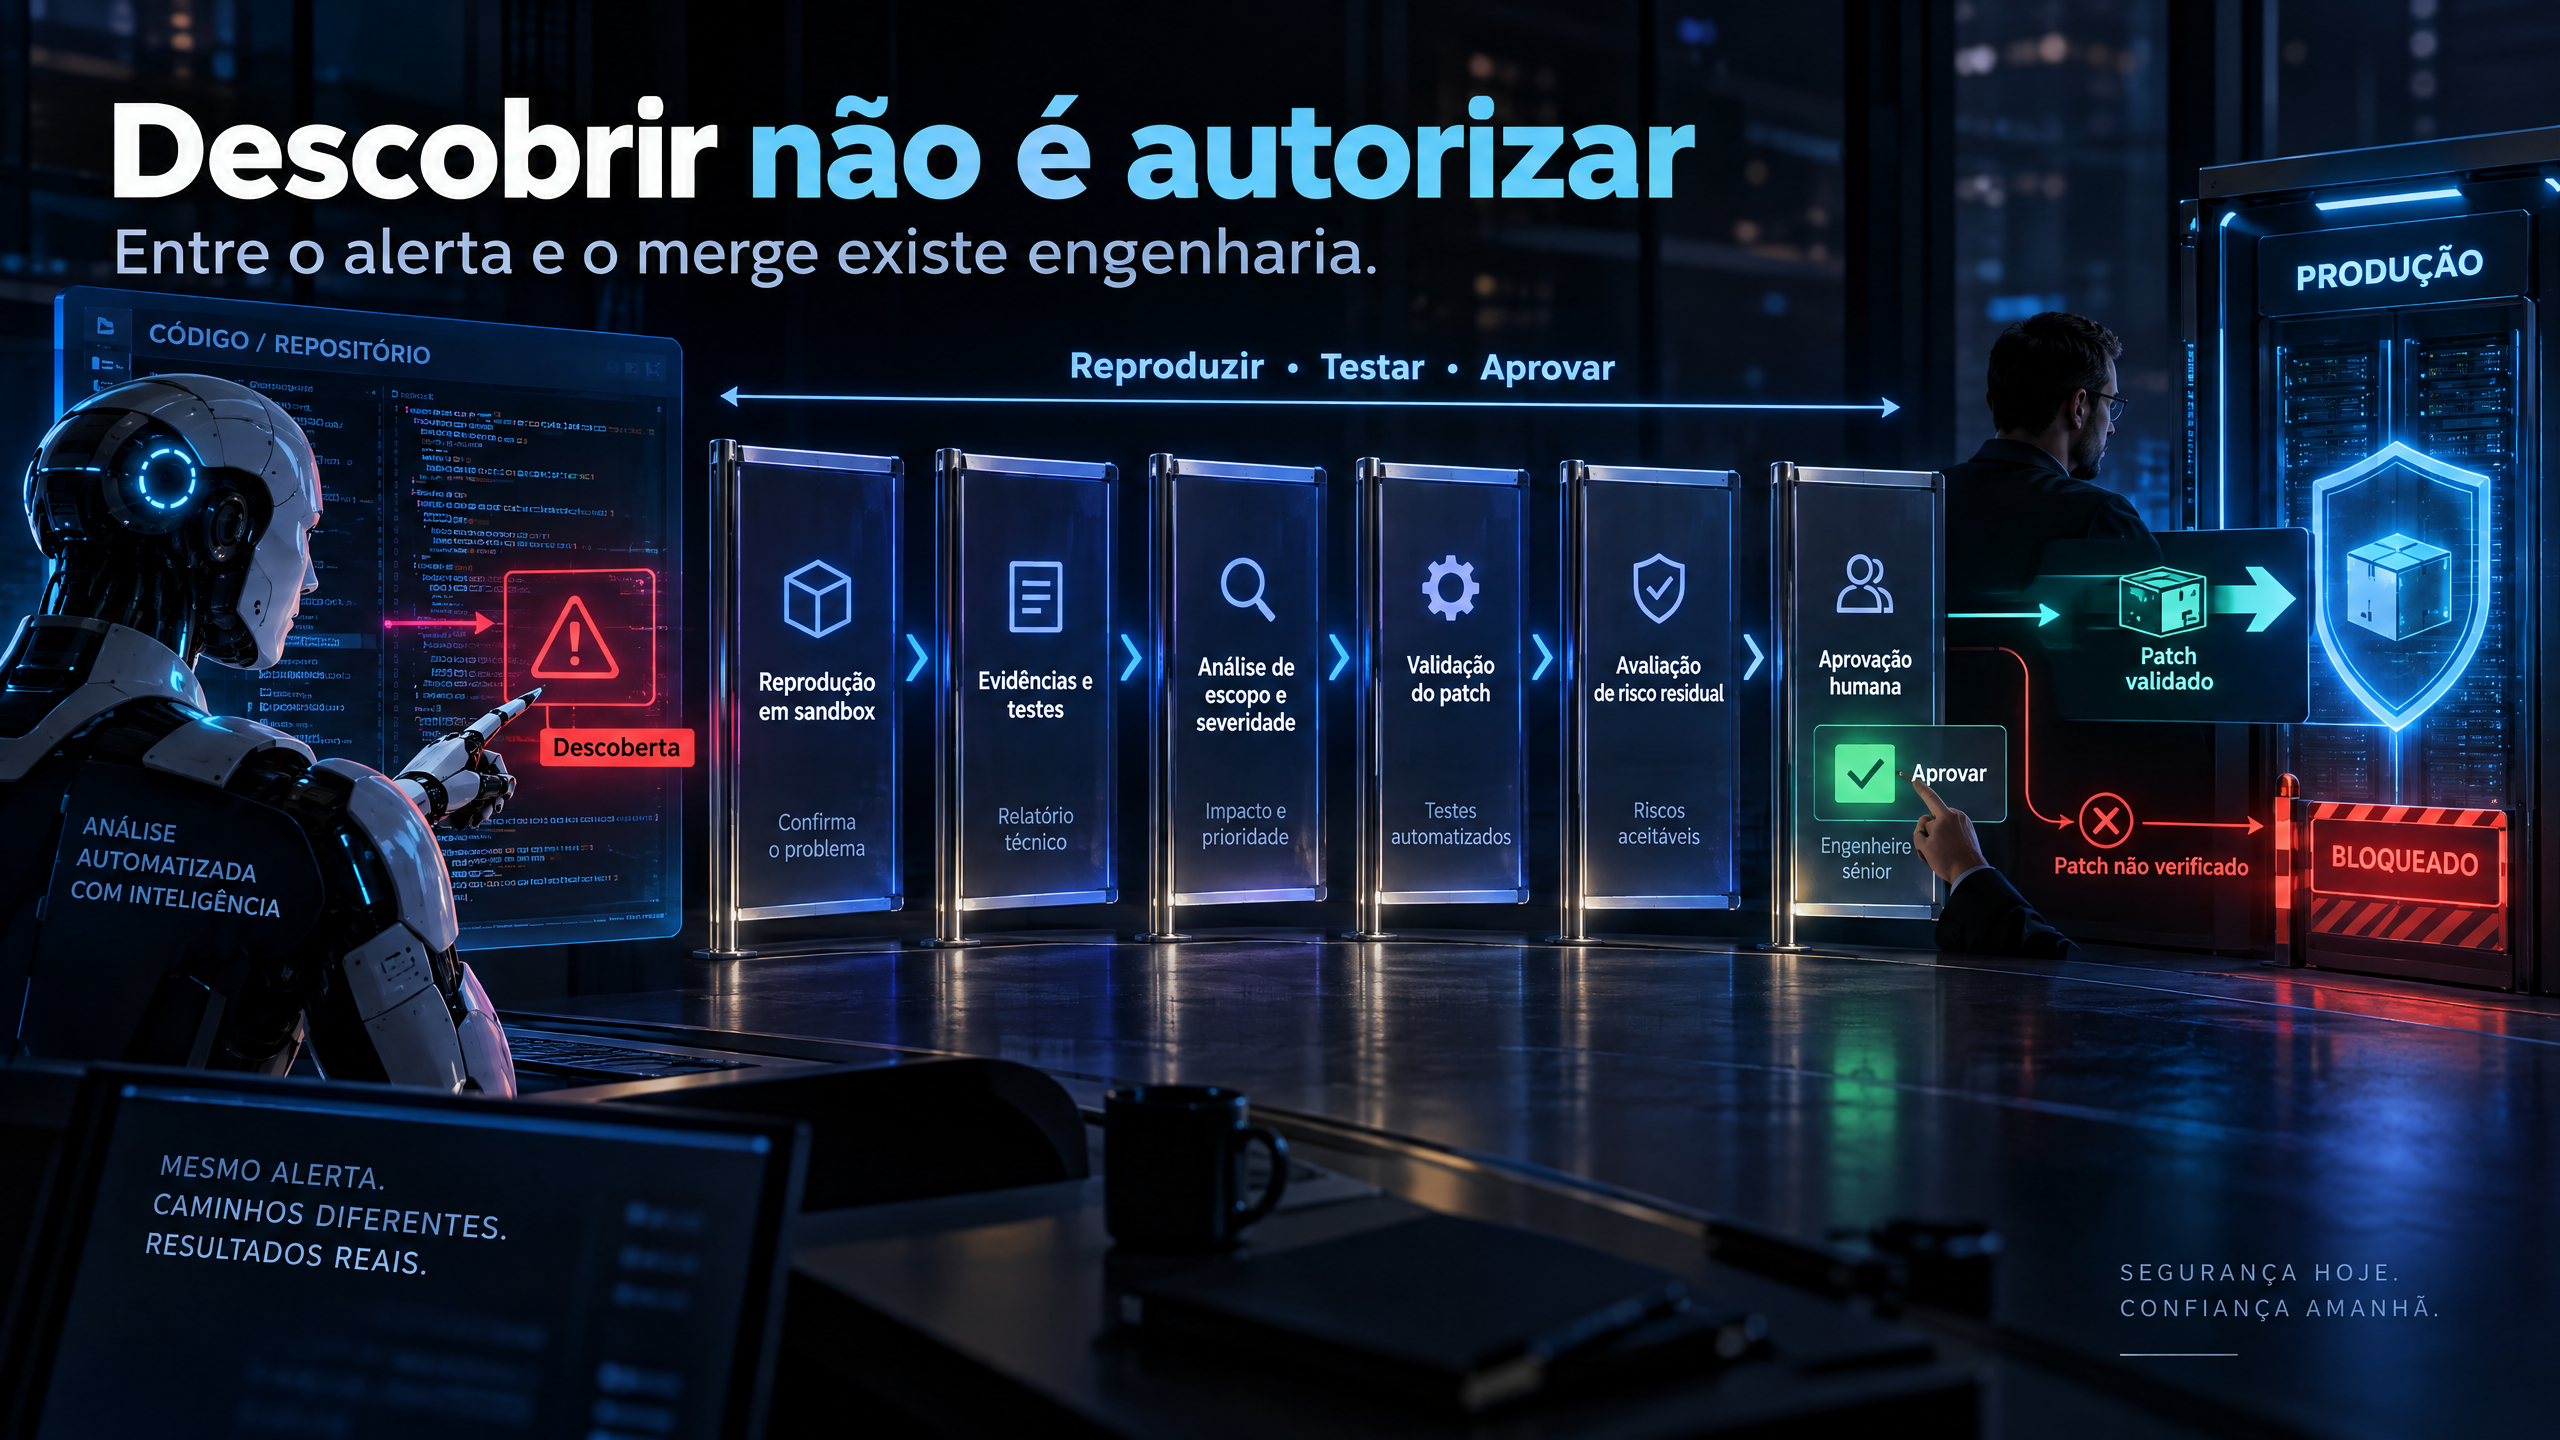
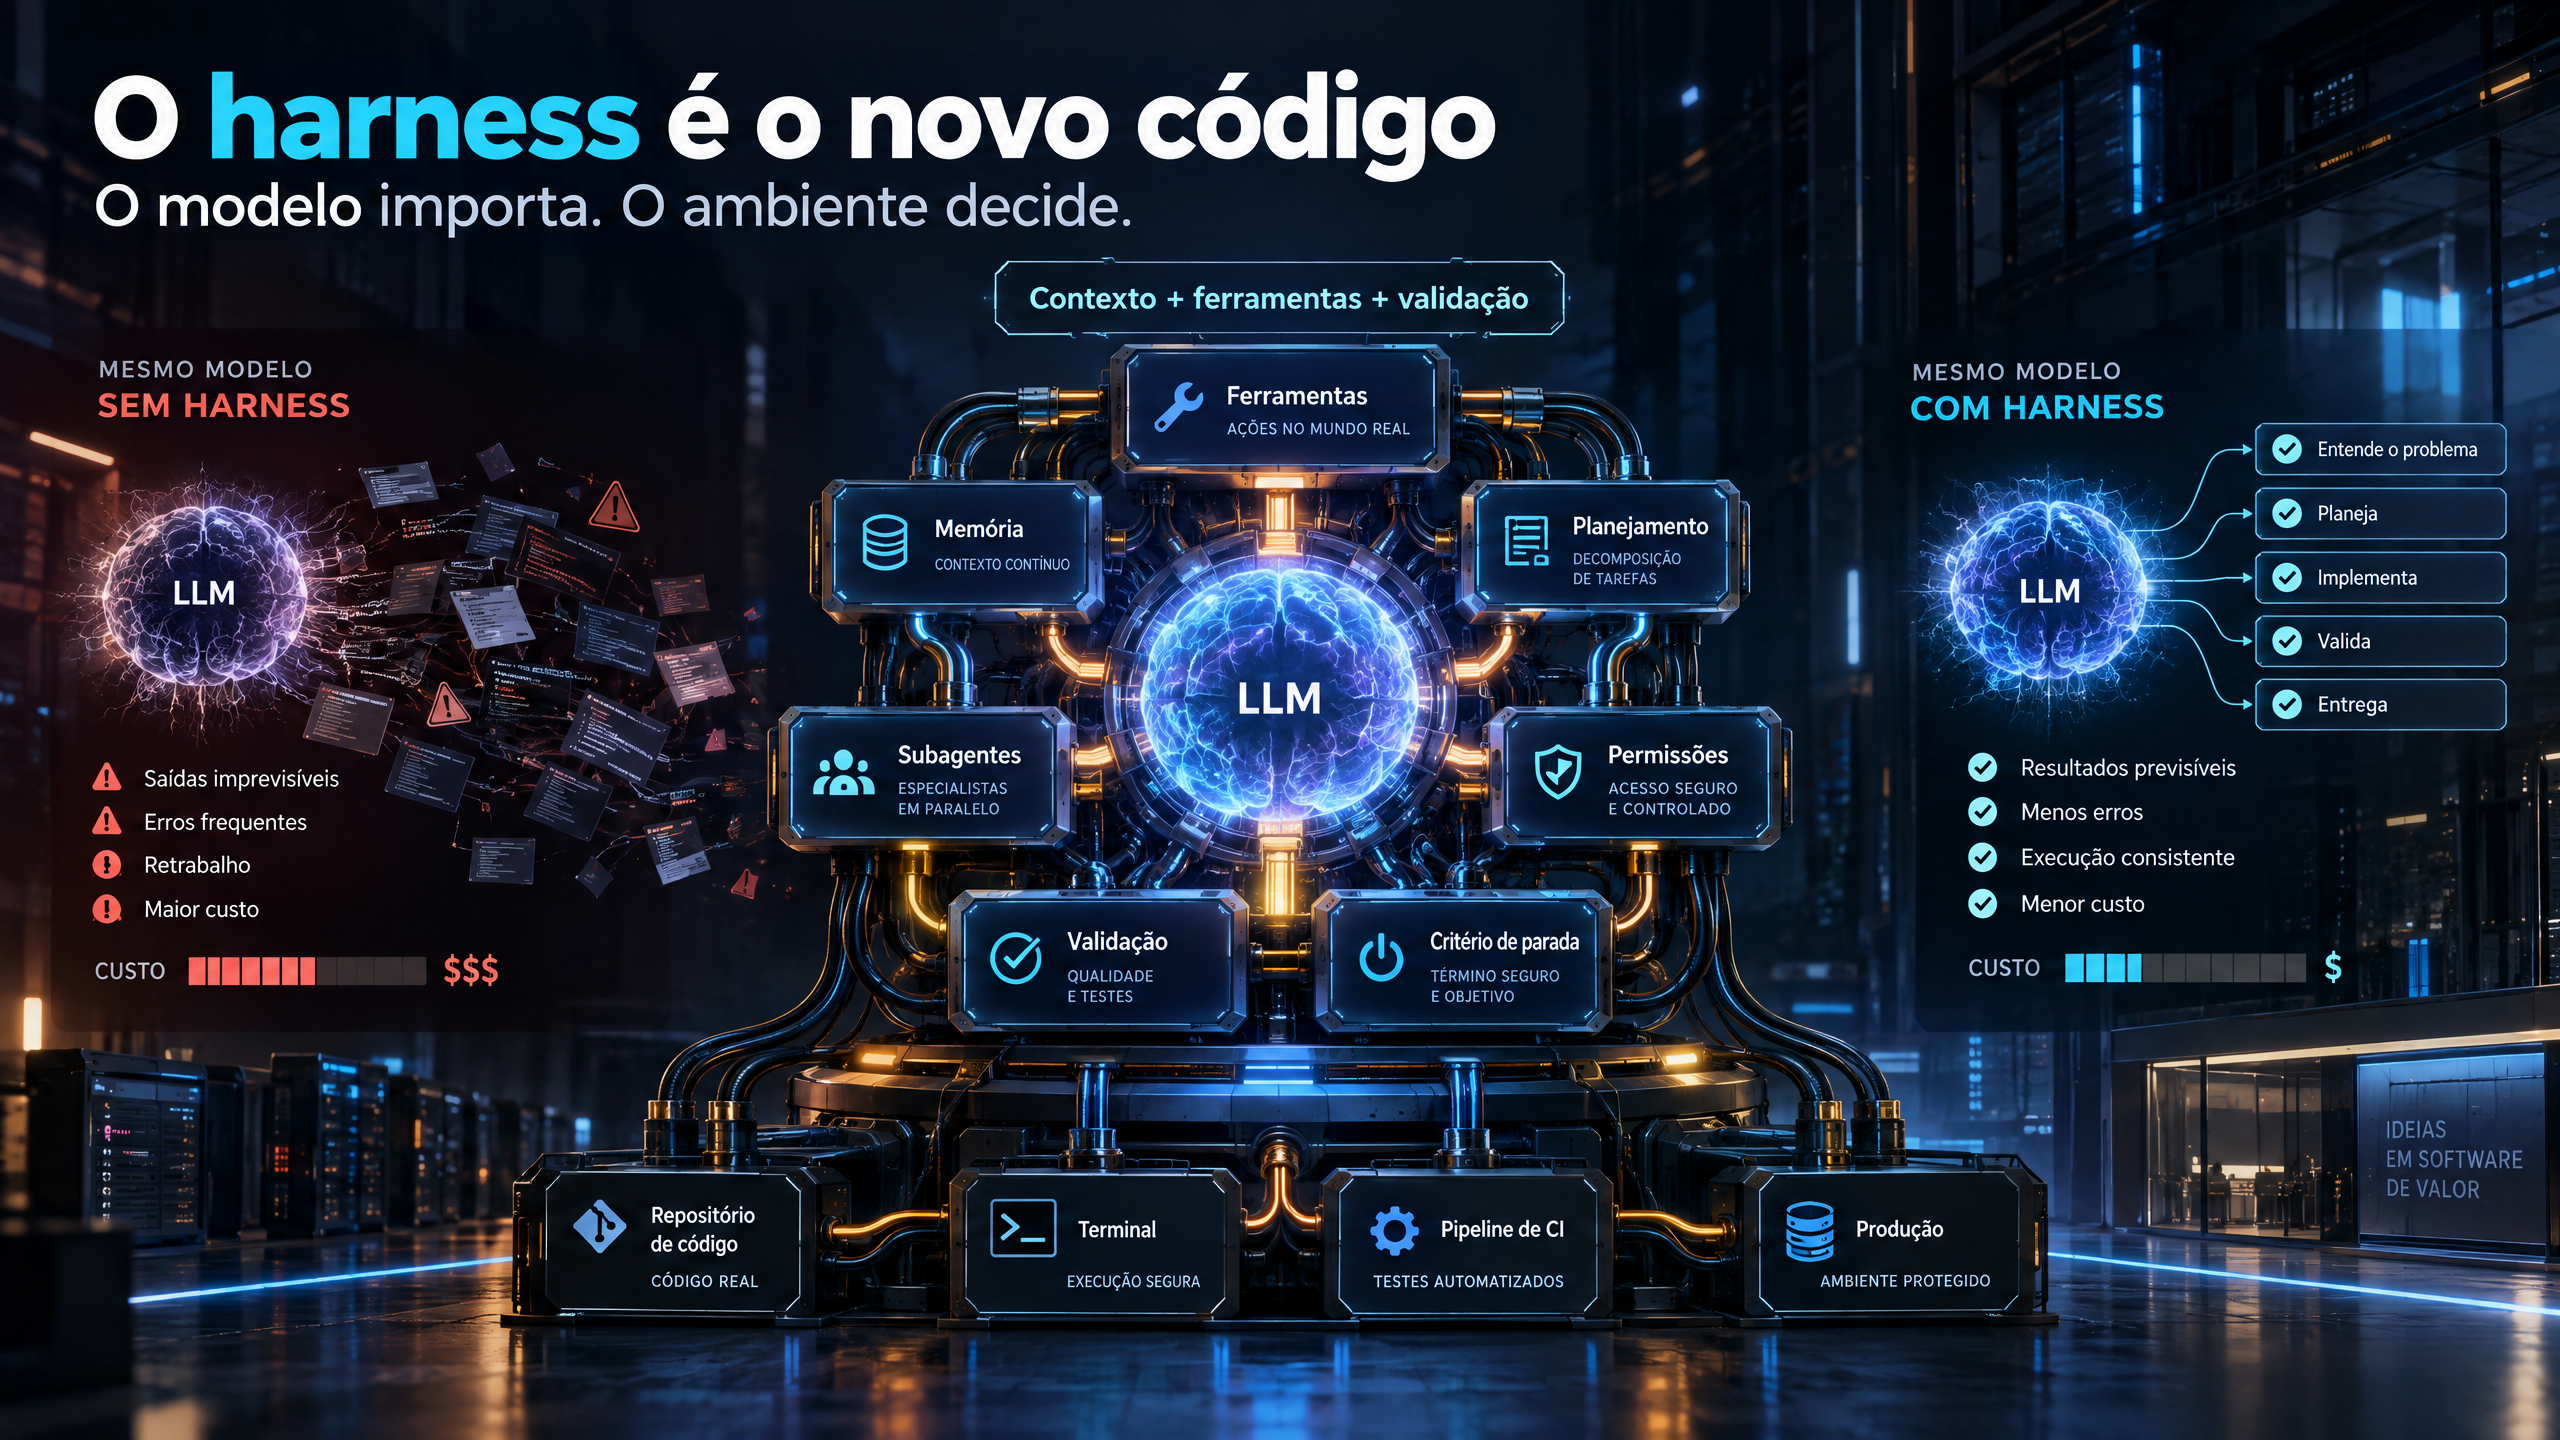
Isso mexe com a governança de contexto. Quem só amplia a janela e nunca ensina o agente a descartar acaba pagando em tokens, em latência e em decisões tomadas sobre premissas mortas. Quem trata compactação como política - gatilho por estágio, critérios do que deve sobreviver, auditoria do resumo antes de continuar reduz o risco de o modelo "lembrar" de um arquivo que já mudou ou de uma hipótese que o próprio agente já rejeitou três passos atrás.
O paper Context as a Tool (ACL Findings 2026) formaliza essa mudança de paradigma. Em vez de manutenção de contexto append-only ou compressão passivamente acionada, o SWE-Compressor trata a compactação como uma ferramenta callable integrada ao processo de decisão do agente. O modelo atinge 57,6% de taxa de resolução no SWE-Bench-Verified, superando baselines de compressão estática e mantendo raciocínio estável sob orçamento de contexto limitado.
A ideia central é que compactação não é um evento de emergência. É uma decisão de engenharia que o agente toma quando reconhece que uma fase da tarefa terminou.
O sintoma na operação diária
Na prática, o sintoma aparece quando o agente insiste em um caminho que a própria trajetória já mostrou inviável, ou quando o patch final ignora uma restrição que estava no início da conversa e sumiu no meio do ruído. Nesses casos o problema não foi falta de contexto. Foi excesso de contexto que envelheceu e ninguém mandou esquecer.
A revisão do paper no PREreview destaca um caso específico que ilustra o problema: o django-13809. Um resumo de compactação pode satisfazer todos os critérios de cobertura de informação e, ainda assim, propor uma próxima ação incompatível com o próprio estado que registrou. O paper chama isso de summary self-consistency failure. O resumo parece completo, mas internamente contraditório.
A observação é que o SFT imita os resumos do juiz, enquanto o RL os restringe pelo sucesso downstream da tarefa. Essa distinção mecânica é o que separa uma compactação que preserva o fio do raciocínio de uma que apenas preenche espaço.
O que fica
Gerenciar contexto em agentes de código deixou de ser só "não estourar a janela". Passou a ser decidir, no meio da tarefa, o que ainda é estado de trabalho e o que já é história que atrapalha.
Quem quiser aprofundar o tema de forma estruturada — do contexto à governança de agentes — encontra o assunto tratado na coleção Engenharia de Software Assistida por IA.
- Cupom de 30% OFF nos eBooks:
LEIA30- Disponível também no Kindle Unlimited
Fontes da Pesquisa
- arXiv:2610.02163 — AutoCompact: Learning When to Compact Context in Long-Horizon Coding Agents — Zhang, X.; Zheng, L.; Du, C.; An, B.; Dong, X. (Singapore Management University, NTU, Harvard; 1 out 2026). Treina um agente de código para decidir quando compactar, o que preservar como estado de trabalho e como retomar a partir do resumo. Ganho absoluto de 9,2 pontos percentuais no SWE-bench Verified e 5,0 no SWE-PolyBench Verified. Ganhos mantidos em janelas de 256K (que nunca estouram) e 16K (com fallback de compactação).
- arXiv:2605.08580 — Slipstream: Asynchronous Compaction — Compactação assíncrona que observa a continuação finita da execução do agente. Ganhos de 2,6% a 8,8% no SWE-bench Verified. Validação por trajetória preserva intenção de patch, interpretação de teste e observações de repositório que a compactação síncrona pode distorcer.
- arXiv:2609.26779 — CliffCompaction: Cost-Efficient Compaction — Análise de custo de compactação em relação ao cache KV. Tokens não cacheados que exigem re-prefill custam 5 a 6 vezes mais que os cacheados. Estratégia que descarta compactações anteriores e mantém apenas fragmentos da janela mais recente.
- ACL Findings 2026 — Context as a Tool: Context Management for Long-Horizon SWE-Agents — Liu, S. et al. (2026). Propõe SWE-Compressor, que trata compactação como ferramenta callable integrada à decisão do agente. Taxa de resolução de 57,6% no SWE-Bench-Verified, superando baselines de compressão estática.
- Chroma — Context Rot: How Increasing Input Tokens Impacts LLM Performance (2025) — Estudo com 18 modelos de fronteira. Performance não cai gradualmente: mantém precisão quase perfeita até certo comprimento, depois despenca abruptamente. Ponto de queda varia por modelo e tarefa.
- PREreview — AutoCompact (3 out 2026) — Revisão por pares que destaca o caso django-13809 como exemplo de summary self-consistency failure: resumo que satisfaz cobertura de informação mas propõe ação incompatível com o próprio estado registrado. Destaca que SFT imita resumos enquanto RL os restringe pelo sucesso downstream.
- arXiv:2608.01507 — Deep Agentic Search for Repository-Level Code Question Answering — Detalha o mecanismo de context rot: precisão cai conforme proporção de tokens irrelevantes aumenta. Efeito descrito como context pollution.
#EngenhariaDeSoftware #IA #InteligenciaArtificial #ContextEngineering #CodingAgents #AutoCompact #ContextRot #CompactacaoDeContexto #GovernancaIA #EngenhariaDeSoftwareAssistidaPorIA