O agente disse "95% de confiança". Quem mediu?
Escores de confiança gerados pelo próprio modelo e o benchmark DecisionPivot mostram por que um número convincente não autoriza sozinho uma decisão.
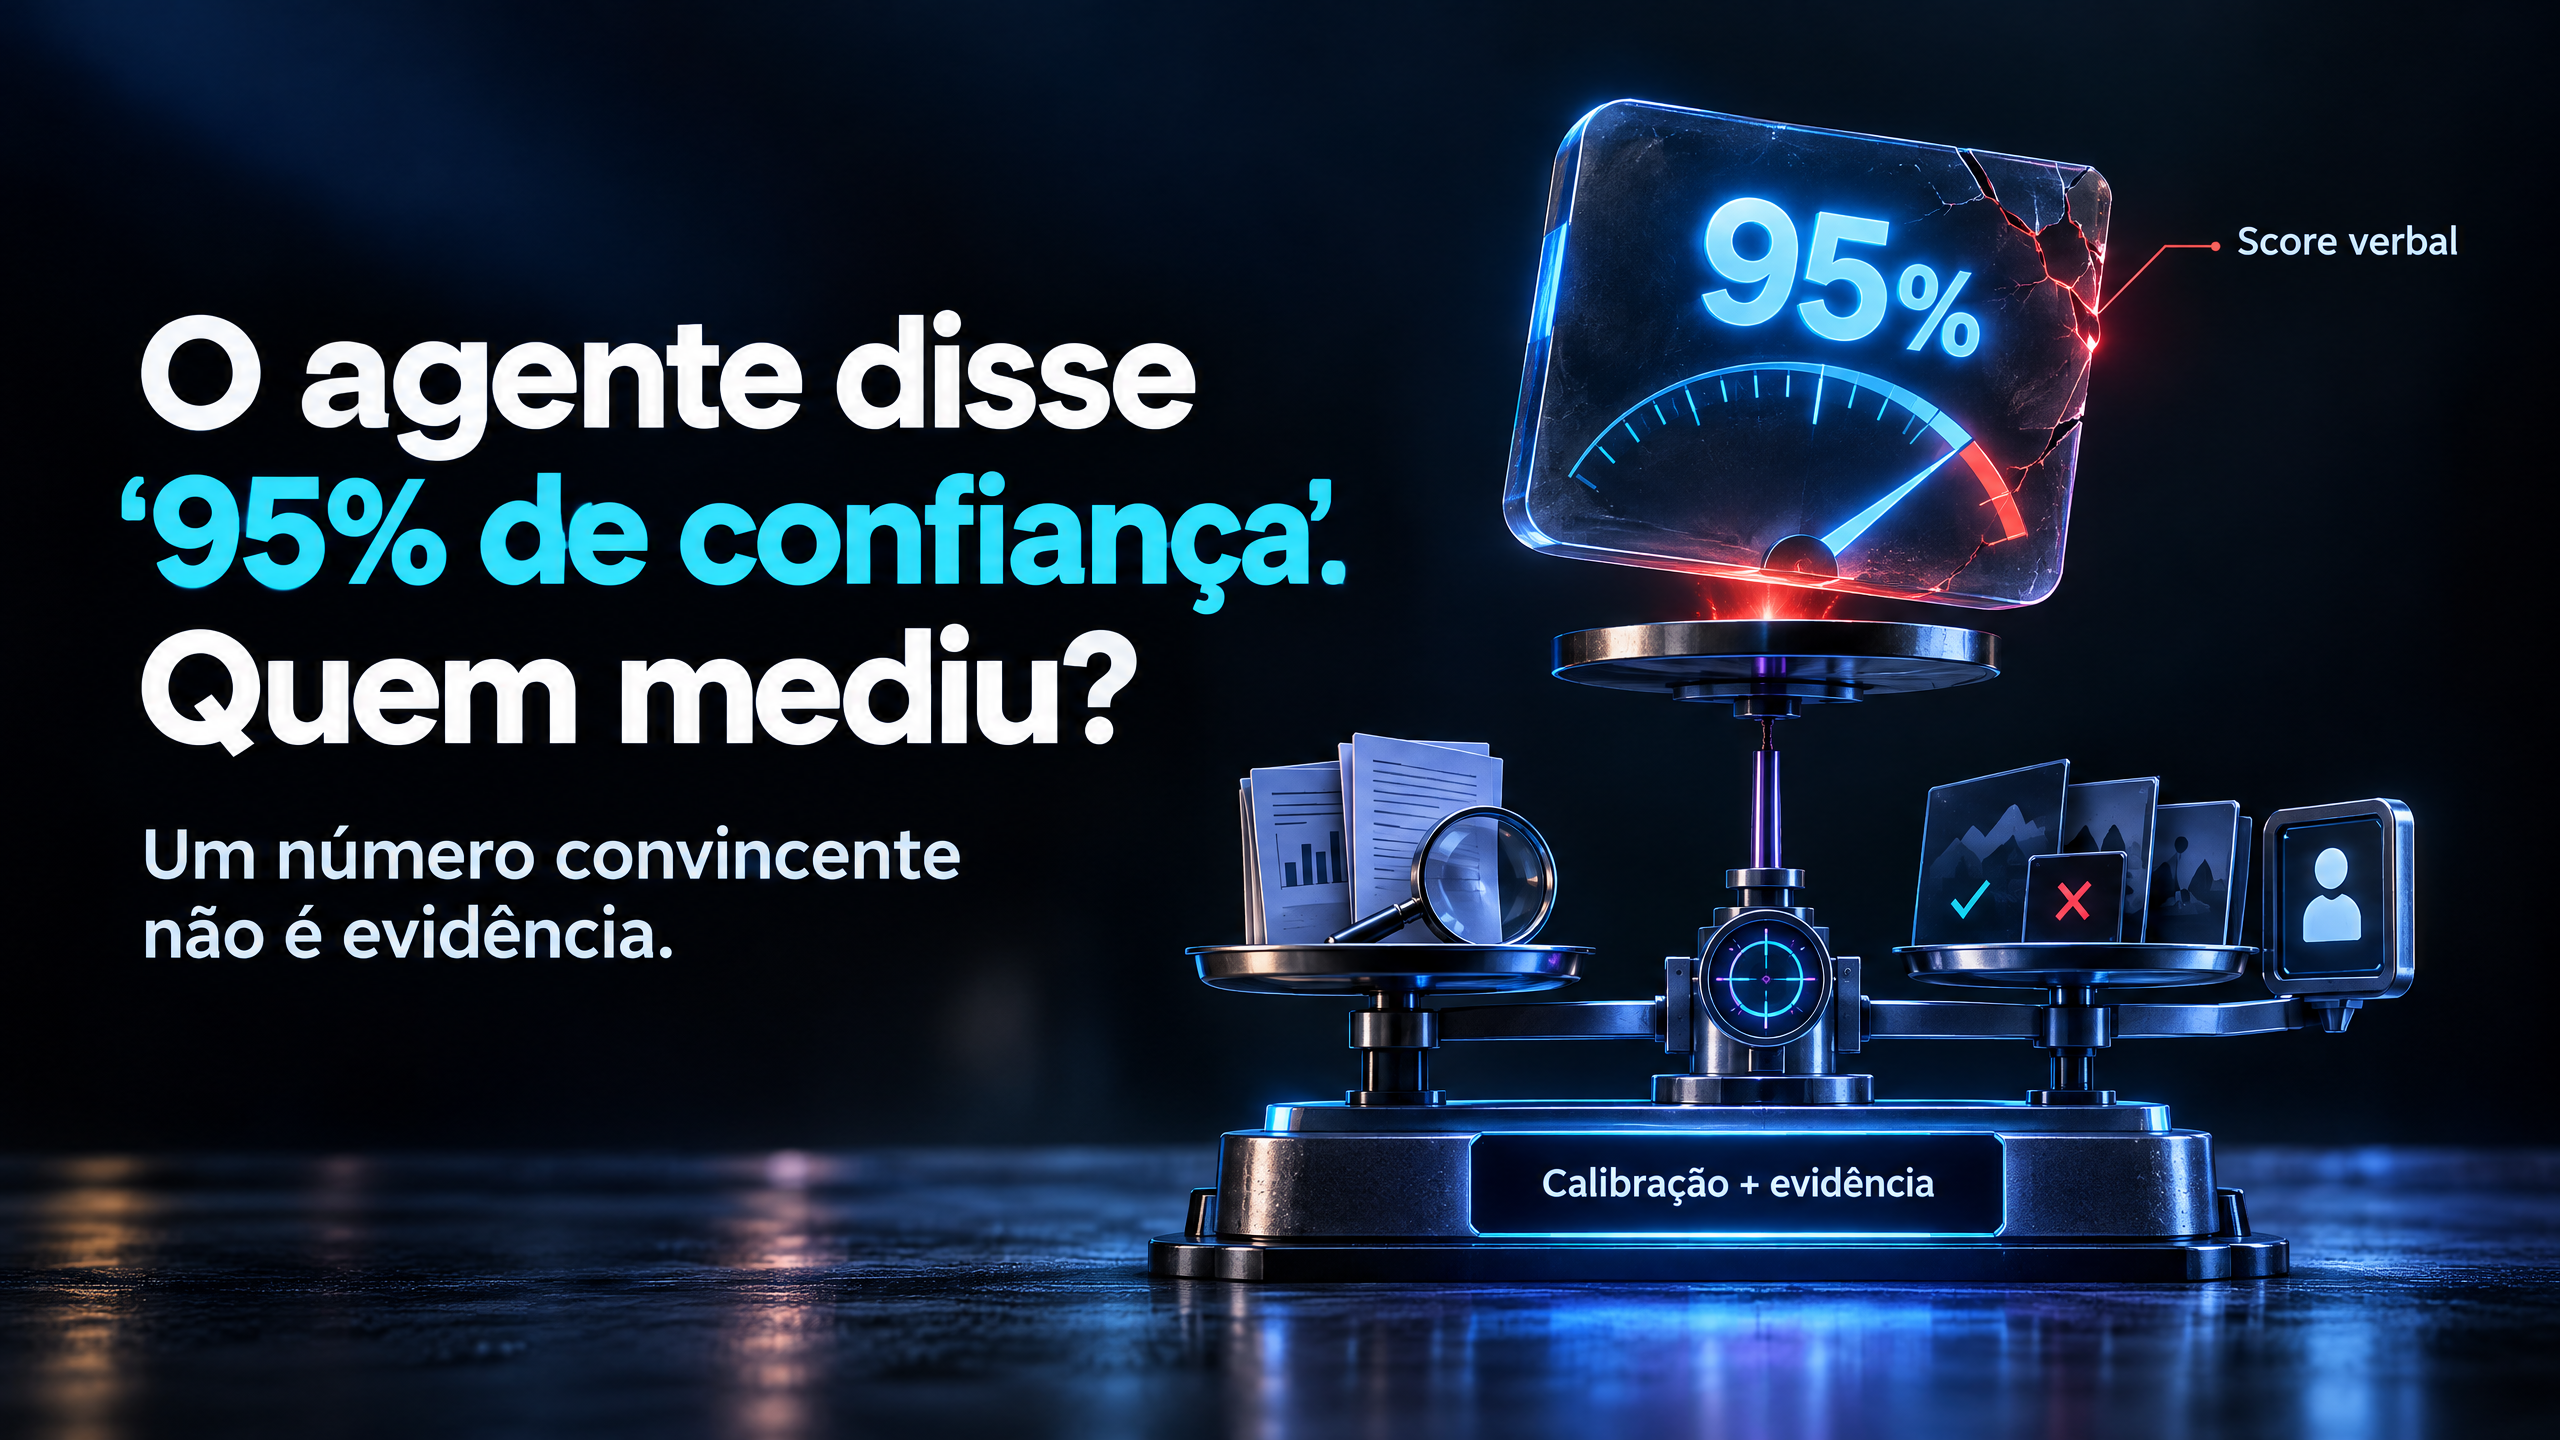
O número chega com uma aura de precisão. O agente devolve o diff, a classificação ou o "pode seguir" acompanhado de um percentual alto, e o time trata aquilo como sinal de que a decisão está madura o suficiente para dispensar revisão. O problema não é o número em si. É a origem dele. Esse percentual, na maioria dos sistemas que o exibem, é uma verbalização do modelo — uma estimativa que o próprio modelo produziu sobre o próprio acerto, sem qualquer vínculo demonstrado com a frequência real de erro naquele domínio. Sem um protocolo de calibração, o número é conforto, não evidência. Em um debate recente no Hacker News, a formulação "não peça escore de confiança a um LLM" gerou dezenas de comentários justamente porque o incômodo é difuso e reconhecível: equipes já tratam escores verbais como gates operacionais sem nunca terem medido se aquele limiar corresponde a algo no mundo.
O paper DecisionPivot, submetido ao arXiv em 20 de outubro de 2026, dá nome ao que esses times estão sentindo na prática. O benchmark reúne 48 tarefas e 40.033 itens em sete papéis de decisão usados em sistemas com LLM — guardrails, verificação de saída, checagem de ferramenta de agente, classificações de raciocínio — e organiza o track central em 7.800 itens de 13 famílias geradas, agrupados em pares de contraste: o mesmo caso com um detalhe plantado que muda a resposta correta, verificado por solvers implementados de forma independente. A métrica que importa não é a acurácia de item isolada. É se o modelo acerta o grupo inteiro, se ordena probabilidades de forma coerente e se as predições de alta confiança realmente erram menos. A acurácia agregada, sozinha, não estabelece nada disso.
Os resultados expõem a distância entre o que um score agregado sugere e o que o sistema entrega quando a variação controlada entra em cena. Dois modelos de 27 bilhões de parâmetros separados por apenas 2,6 pontos no track de referência chegaram a 70,1% e 44,2% de acurácia em grupos de contraste — uma diferença de quase vinte e seis pontos percentuais escondida atrás de um número que parecia quase idêntico. Em 2.400 pares binários, um decisor ordenou corretamente o membro positivo acima do negativo em 92,3% dos casos, mas acertou os dois membros do par em apenas 74,1%. Ordenar probabilidades e decidir corretamente são habilidades distintas; um modelo pode parecer bem calibrado na superfície enquanto falha na decisão conjunta que o pipeline realmente exige.
O fator ferramenta e a calibração em código
A questão da confiança verbal tem uma camada adicional que o DecisionPivot não resolve e que a literatura sobre agentes com ferramentas começa a mapear. O paper The Confidence Dichotomy, apresentado na ACL 2026, mostra que a calibração verbal em agentes que usam ferramentas não é uniforme: ferramentas de evidência, como busca na web, induzem sistematicamente a uma superconfiança severa por causa do ruído inerente à informação recuperada, enquanto ferramentas de verificação, como interpretadores de código, conseguem ancorar o raciocínio em feedback determinístico e mitigar o desalinhamento. O tipo de ferramenta que o agente usa muda a forma como ele expressa confiança, e nenhum limiar universal de "90%" sobrevive a essa variação sem uma camada de validação por domínio.
O cenário de código não escapa. Um estudo de 2026 publicado na FSE, conduzido com mais de 24 milhões de interações reais de IDE, testou se um calibrador genérico de Platt scaling — a abordagem padrão de pós-processamento para alinhar escores de confiança à frequência de acerto — melhora a utilidade da confiança como sinal de confiabilidade em assistentes de código. A resposta foi negativa: o calibrador geral não melhorou de forma consistente essa utilidade, e a calibração personalizada só começou a fazer diferença quando havia dados suficientes de interação do usuário para treinar o ajuste. Em outras palavras, o escore que um agente de codificação devolve não se torna confiável apenas porque passou por uma transformação matemática padrão. Ele precisa ser medido contra o comportamento de aceitação real naquele contexto de uso, com aquele time, naquele repositório, naquelas práticas de revisão.
O perigo dos limiares arbitrários
Há um detalhe do DecisionPivot que merece atenção separada porque atinge diretamente a lógica de roteamento e de guardrail. Modelos com acurácia de item parecida divergem na confiabilidade das predições que fazem com probabilidade igual ou superior a 0,90: um erra menos quando se declara muito confiante, outro declara confiança alta com mais frequência e erra mais nesses casos. Se o pipeline usa "probabilidade \(\ge 0,90\)" como critério para encaminhar uma saída sem revisão humana, o desempenho desse gate depende de qual modelo está por trás do número, e essa dependência não aparece em nenhum dashboard que agrega acurácia média. Um segundo modelo, ou um teste, ou uma trilha de evidência — qualquer um desses pode ser mais defensável do que um limiar importado de um benchmark que não modela o custo do erro naquele fluxo específico.
A implicação operacional não é abandonar escores de confiança. É recusar a transformação silenciosa de um escore verbal em autorização. "Confiança acima de 90%" só vira critério defensável se alguém, em algum momento, medido no domínio do time se esse limiar corresponde a uma taxa de erro que o processo consegue absorver. Sem essa medição, o número funciona como um atalho para automatizar o que ainda precisava de revisão — e o atalho é particularmente perigoso porque vem embalado em uma linguagem que parece técnica, precisa e objetiva. Um agente que diz "95%" não está comunicando uma probabilidade calibrada. Está produzindo uma frase sobre si mesmo. A pergunta que falta no fluxo de aprovação não é se o número parece alto. É quem o mediu, contra qual conjunto rotulado, e com qual taxa de erro observada.
Aprofunde-se no tema de forma estruturada — supervisão, auditoria e o que realmente autoriza uma decisão do agente — consultando a coleção Engenharia de Software Assistida por IA, disponível na Amazon e no Kindle Unlimited.
Acesse a landing page da série
Cupom de 30% OFF:
LEIA30
Fontes de pesquisa consultadas
Zhuang et al. — DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems (arXiv:2610.28522, out. 2026).
The Confidence Dichotomy: Analyzing and Mitigating Miscalibration in Tool-Use Agents (ACL 2026).
Estudo sobre calibração de confiança em assistentes de código com 24 milhões de interações de IDE (FSE 2026 / Empirical Software Engineering).
Discussão no Hacker News sobre escores de confiança em LLMs (out. 2026).
Simon Willison's Weblog (2026) — entradas sobre calibração, agentes e confiança verbal.
Using Claude to reduce the attack surface of code (out. 2026), Anthropic Research — referência cruzada sobre o que um agente herda e expõe.
OpenAI News e DeepMind Blog — publicações recentes sobre calibração e avaliação de agentes (2025-2026).
The Batch (DeepLearning.AI) — cobertura sobre benchmarks de decisão em sistemas com LLM (2026).
arXiv
cs.AI— RSS de artigos sobre calibração e confiabilidade em LLMs (out. 2026).
#EngenhariaDeSoftware #IA #InteligenciaArtificial #SoftwareEngineering #Calibracao #Agentes #Auditoria #Confiabilidade #DecisionPivot #LLM #EngenhariaDeSoftwareAssistidaPorIA
About the author
- Engenheiro de Software Sênior e Arquiteto de Soluções com anos de experiência construindo sistemas distribuídos e de alta criticidade. Autor da série de livros "Engenharia de Software Assistida por IA". Escrevo sobre arquitetura de software, ecossistema .NET, engenharia de contexto, MCP e como utilizar agentes de IA para criar sistemas robustos. Livros na Amazon: https://www.amazon.com.br/stores/author/B0H7VR7VS3/allbooks ---------------- Senior Software Engineer & Solution Architect with over 20 years of experience building scalable, distributed systems. Author of "Engenharia de Software Assistida por IA". Writing about modern software architecture, .NET, context engineering, MCP, and AI-assisted development. Books on Amazon: https://www.amazon.com.br/stores/author/B0H7VR7VS3/allbooks
Comments
Join the discussionNo comments yet. Be the first to comment.