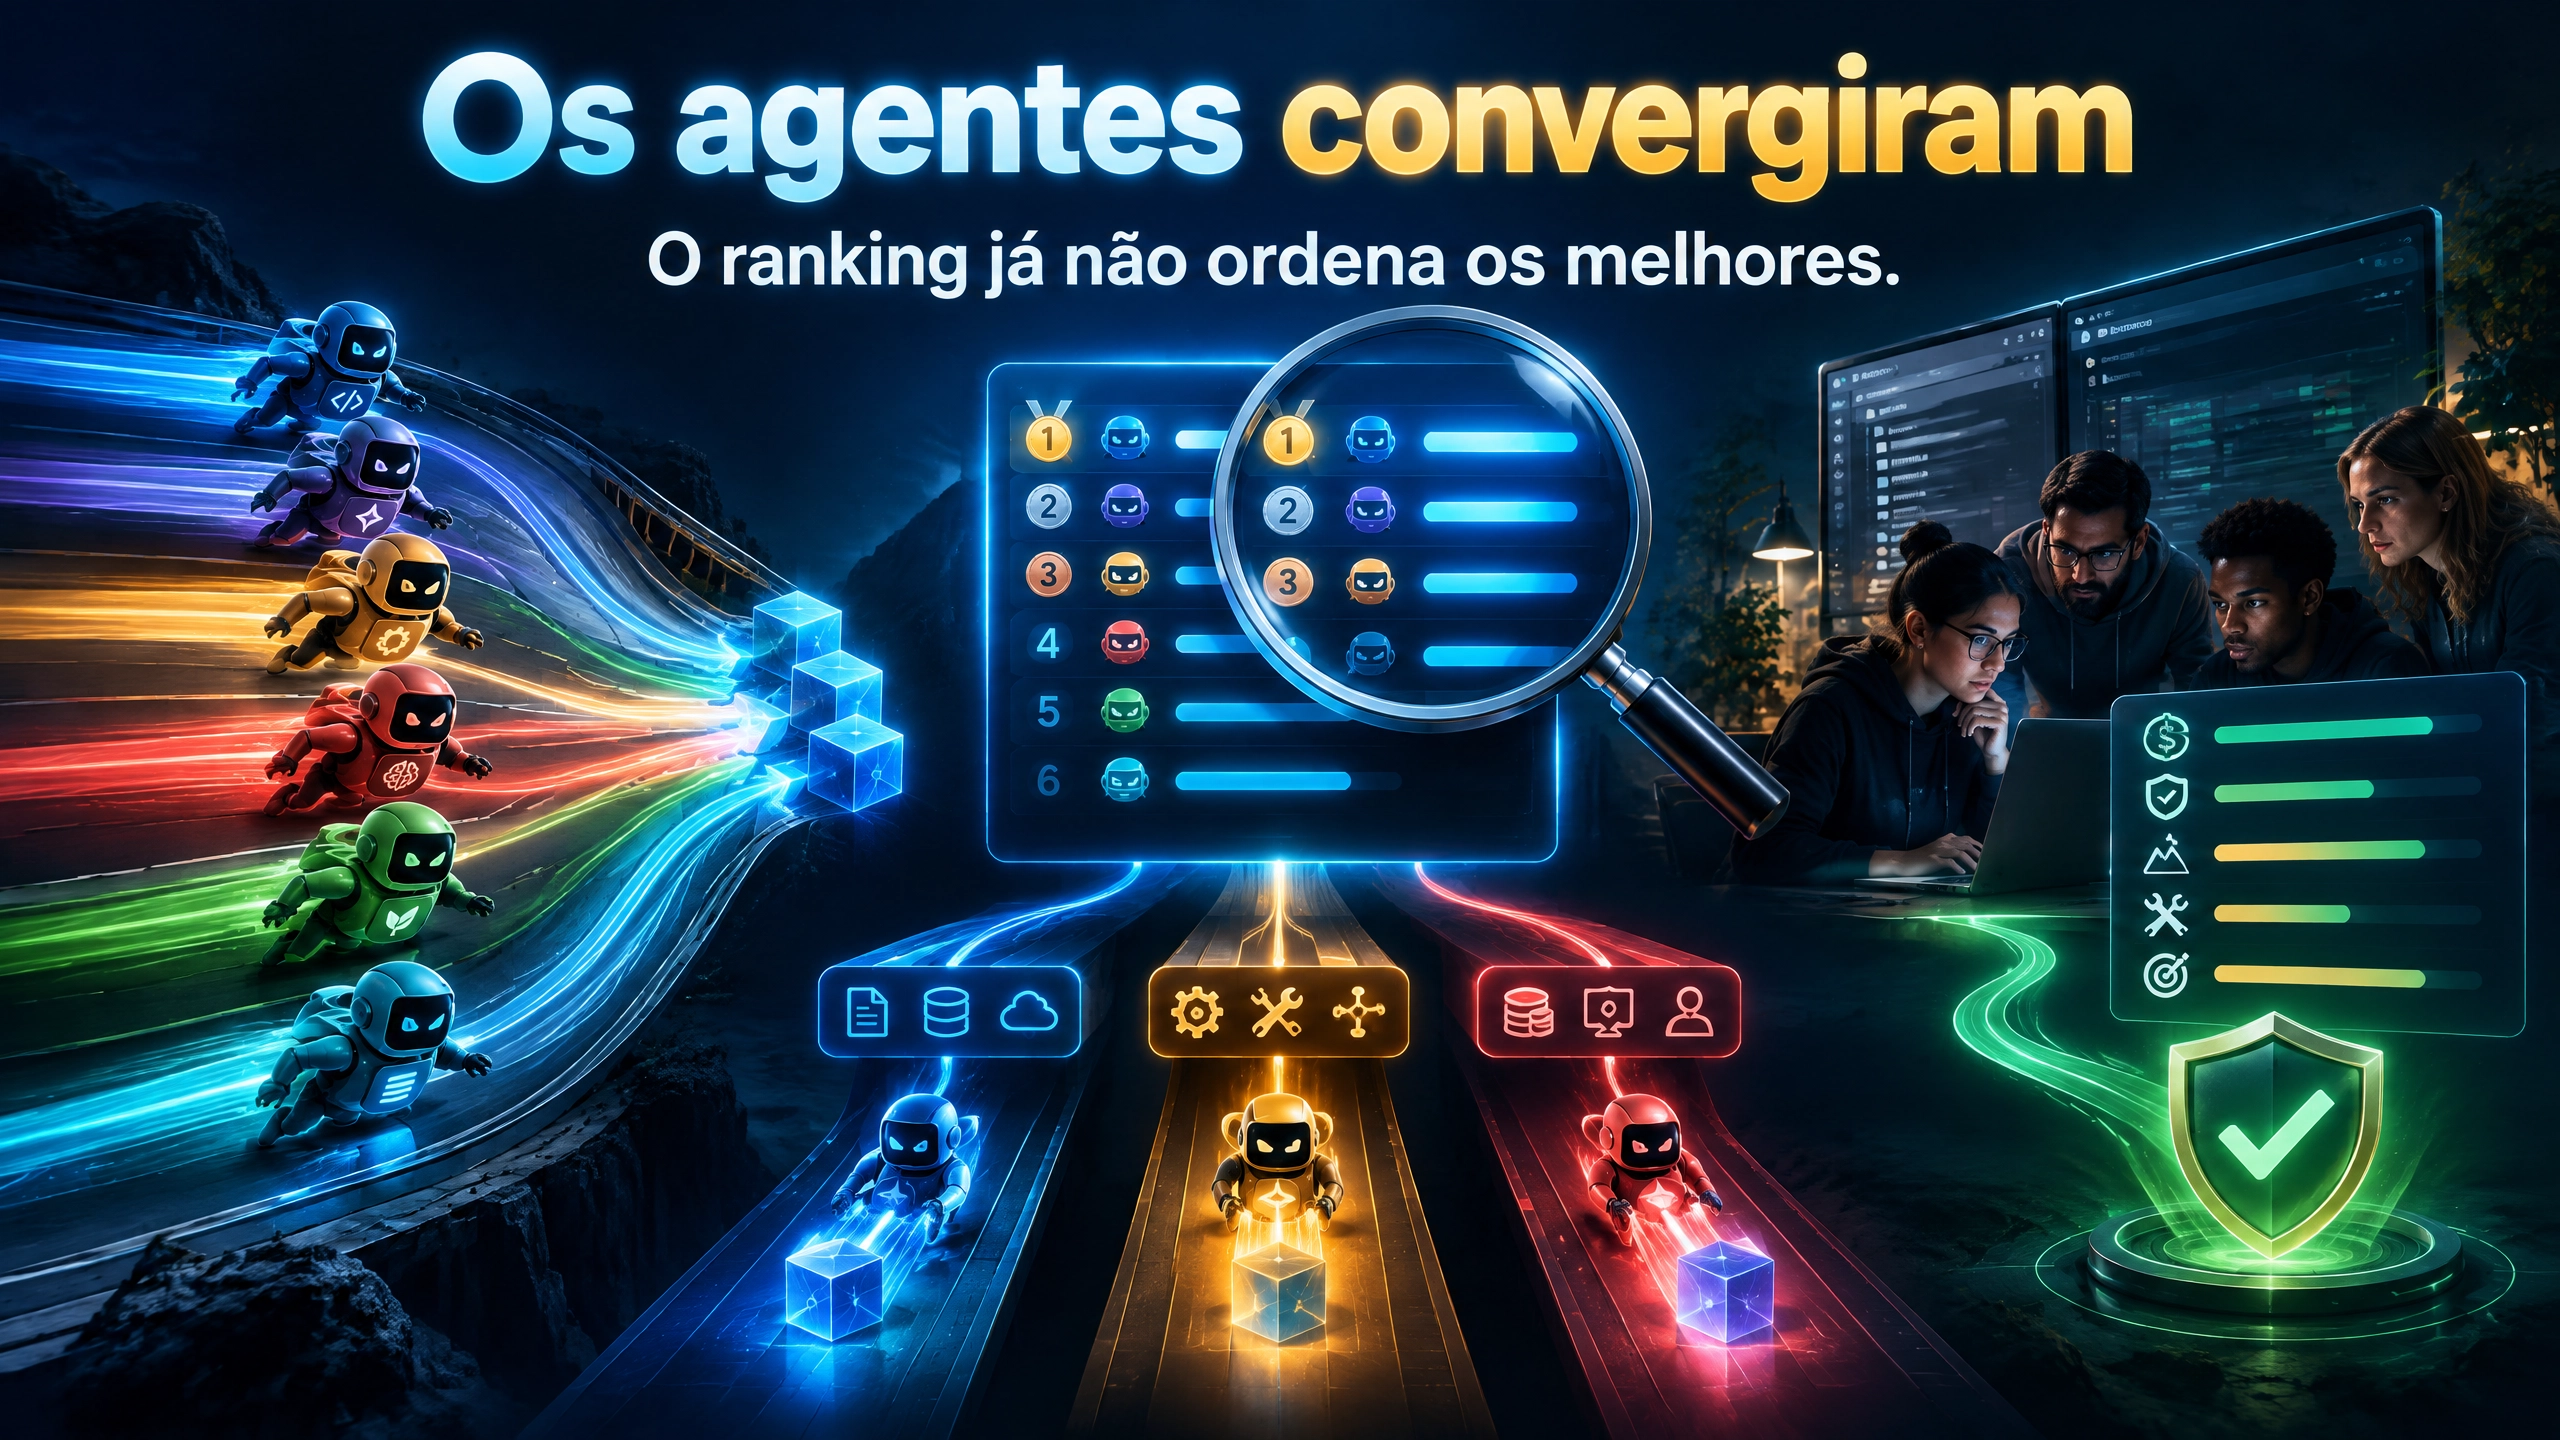
Nem todo agente é igual
O que 37 mil PRs estão revelando sobre a qualidade depois do merge
O agente abre o pull request. O time aprova. O que acontece depois?
Um estudo recente analisou 37.623 PRs com proveniência marcada de cinco agentes comerciais — OpenAI Codex, Devin, GitHub Copilot, Cursor e Claude Code —, além de um baseline humano. Foram mapeados 2.807 repositórios no GitHub entre dezembro de 2024 e julho de 2025.
Três resultados se destacam — e nenhum deles se resume às frases simplistas "agentes são melhores" ou "agentes são piores".
"O agente abre o pull request. O time aprova. O que acontece depois é o que separa a ferramenta que ajuda da ferramenta que só adiciona fila."
1. Taxa de Revert (Reversão pós-merge)
A frequência com que o código aceito precisa ser revertido varia drasticamente entre as ferramentas:
| Agente / Origem | Taxa de Revert (Estudo Principal) | Taxa de Revert (Estudo MSR 2026) | Perfil e Interpretação |
|---|---|---|---|
| OpenAI Codex | 6,1% (Odds Ratio ~0.5x vs Humano) | 0,72% (6x menor que humano) | Geração conservadora, alinhamento com padrões estabelecidos e tarefas bem delimitadas. |
| Cursor | Não especificado | 2,34% | Mantém taxa de reversão substancialmente abaixo da média humana. |
| Humano (Baseline) | 11,5% | 4,68% | Referência de desenvolvimento manual. |
| Devin | 14,5% (Odds Ratio 1,31x vs Humano) | 6,03% | Maior probabilidade de reversão que o baseline humano. |
| Claude Code | Não especificado | 7,21% | Propõe escopos mais amplos e refatorações que aumentam o risco pós-merge. |
| GitHub Copilot | Não especificado | 7,57% (62% maior que humano) | Sugestões exploratórias e maior taxa de commits de reversão contidos no PR. |
2. Security Smells e Débito de Segurança
No agregado geral, o código gerado por agentes apresentou 37% menos chance de conter um security smell em comparação ao código humano (Odds Ratio 0,63), puxado principalmente pela redução de credenciais hardcoded e uso de eval em tarefas rotineiras.
Porém, quando o escopo é filtrado apenas para caminhos de alto risco (CI/CD, containers, IaC, gerenciamento de secrets e scripts de shell em 16.370 mudanças de arquivos):
- 38,9% dos PRs de agentes continham pelo menos um security smell.
- Integridade da Supply Chain respondeu por 82,3% dos smells detectados (tags mutáveis de Actions/imagens Docker e instalações globais não fixadas).
- Sobreasignação de privilégios e secrets somaram 9,6% e 3,4%, respectivamente.
- Credenciais Hardcoded: Corresponderam a 99,6% dos smells críticos. Contudo, a análise de atribuição revelou que colaboradores humanos — e não os agentes — foram responsáveis por introduzir 67,6% dos secrets genuinamente vazados em fluxos assistidos por IA.
- Taxas por Agente: O Copilot registrou a maior taxa de smells em áreas de risco (45,5%), enquanto o Codex teve a menor (34,9%).
3. Esforço e Tempo de Code Review
A carga de revisão humana não é distribuída de forma uniforme e varia com o perfil do agente:
- GitHub Copilot: Registrou a maior frequência de pedidos de mudança (22,6%) e uma taxa de rejeição explícita de 11,1% em 116.000 repositórios.
- Claude Code: Tende a gerar os maiores patches — média de 34 arquivos modificados e 8.647 linhas alteradas por requisição. Isso exigiu uma média de 3,4 reviews por PR e gerou a maior espera pelo primeiro review (mediana de 12,6 horas).
- Agentes Autônomos (Devin e Claude Code): Enfrentaram os ciclos de vida mais longos para integração final (12,6 horas e 14,7 horas, respectivamente). O gargalo não foi o tempo de computação do agente, mas o escrutínio assíncrono rigoroso dos revisores humanos.
O que isso significa na prática
Qualidade pós-merge é o verdadeiro indicador de valor de um agente. Analisando 1.210 PRs de bug-fix em repositórios Python com o SonarQube, pesquisadores confirmaram que o sucesso no merge não reflete a qualidade do código entregue: as diferenças brutas de issues desaparecem quando normalizadas pelo tamanho do PR, dominadas por code smells graves e bugs pouco frequentes, porém severos.
Tratar "agente de IA" como uma categoria única esconde nuances operacionais críticas. Para quem opera em produção, a pergunta relevante é: qual agente utilizar para qual tipo de mudança, considerando o custo de revisão e o perfil de risco pós-merge?
📖 Governança e Auditoria de Código
Para se aprofundar na estruturação de processos de supervisão e auditoria de código gerado por IA, confira o Volume VI — Supervisão e Auditoria de Código Gerado por IA da série Engenharia de Software Assistida por IA.
💡 Destaques:
- 🏷️ Cupom de 30% OFF nos eBooks:
LEIA30 - 📖 Disponível também no Kindle Unlimited!
👉 Série eBook completa:
📖 Livros Físicos (capa comum):
- 📘 Volume I - A Nova Realidade da Engenharia de Software
- 📙 Volume II - Fundamentos que a IA Não Substitui
- 📗 Volume III - Engenharia de Requisitos na Era da IA
- 📕 Volume IV - Arquitetura e Design de Soluções na Era da IA
- 📓 Volume V - Delegação Técnica para IA
- 📔 Volume VI - Supervisão e Auditoria de Código Gerado por IA
- 📒 Volume VII - Aplicações Reais
- 📗 Volume VIII - Engenharia de Contexto e Governança de IA
🔗 Página do autor na Amazon:
📚 Fontes da Pesquisa
- Not All Agents Are Equal: Code Quality and Post-Merge Maintenance Across Five Autonomous Coding Agents in the Wild – arXiv, setembro/2026. Kraishan, O. Estudo de 37.623 PRs em 2.807 repositórios.
- When AI Code Doesn't Stick: An Empirical Study on Reverted Changes Introduced by AI Coding Agents – MSR 2026. Análise de 1.141 commits de revert em 893 PRs.
- Trust but Verify? Uncovering the Security Debt of Autonomous Coding Agents – arXiv, julho/2026. Análise de 16.370 mudanças de arquivo em 4.064 PRs de alto risco.
- Beyond Bug Fixes: An Empirical Investigation of Post-Merge Code Quality Issues in Agent-Generated Pull Requests – arXiv, janeiro/2026. Análise com SonarQube em 1.210 PRs de bug-fix.
- AI Coding Agents in Production: A Large-Scale Analysis of Pull Request Lifecycles – Análise de 933.000 PRs e ciclos de vida de desenvolvimento.
#EngenhariaDeSoftware #AgentesDeIA #CodeQuality #CodeReview #PostMerge #SWEBench #Seguranca #GovernancaIA #FuturoDaEngenharia