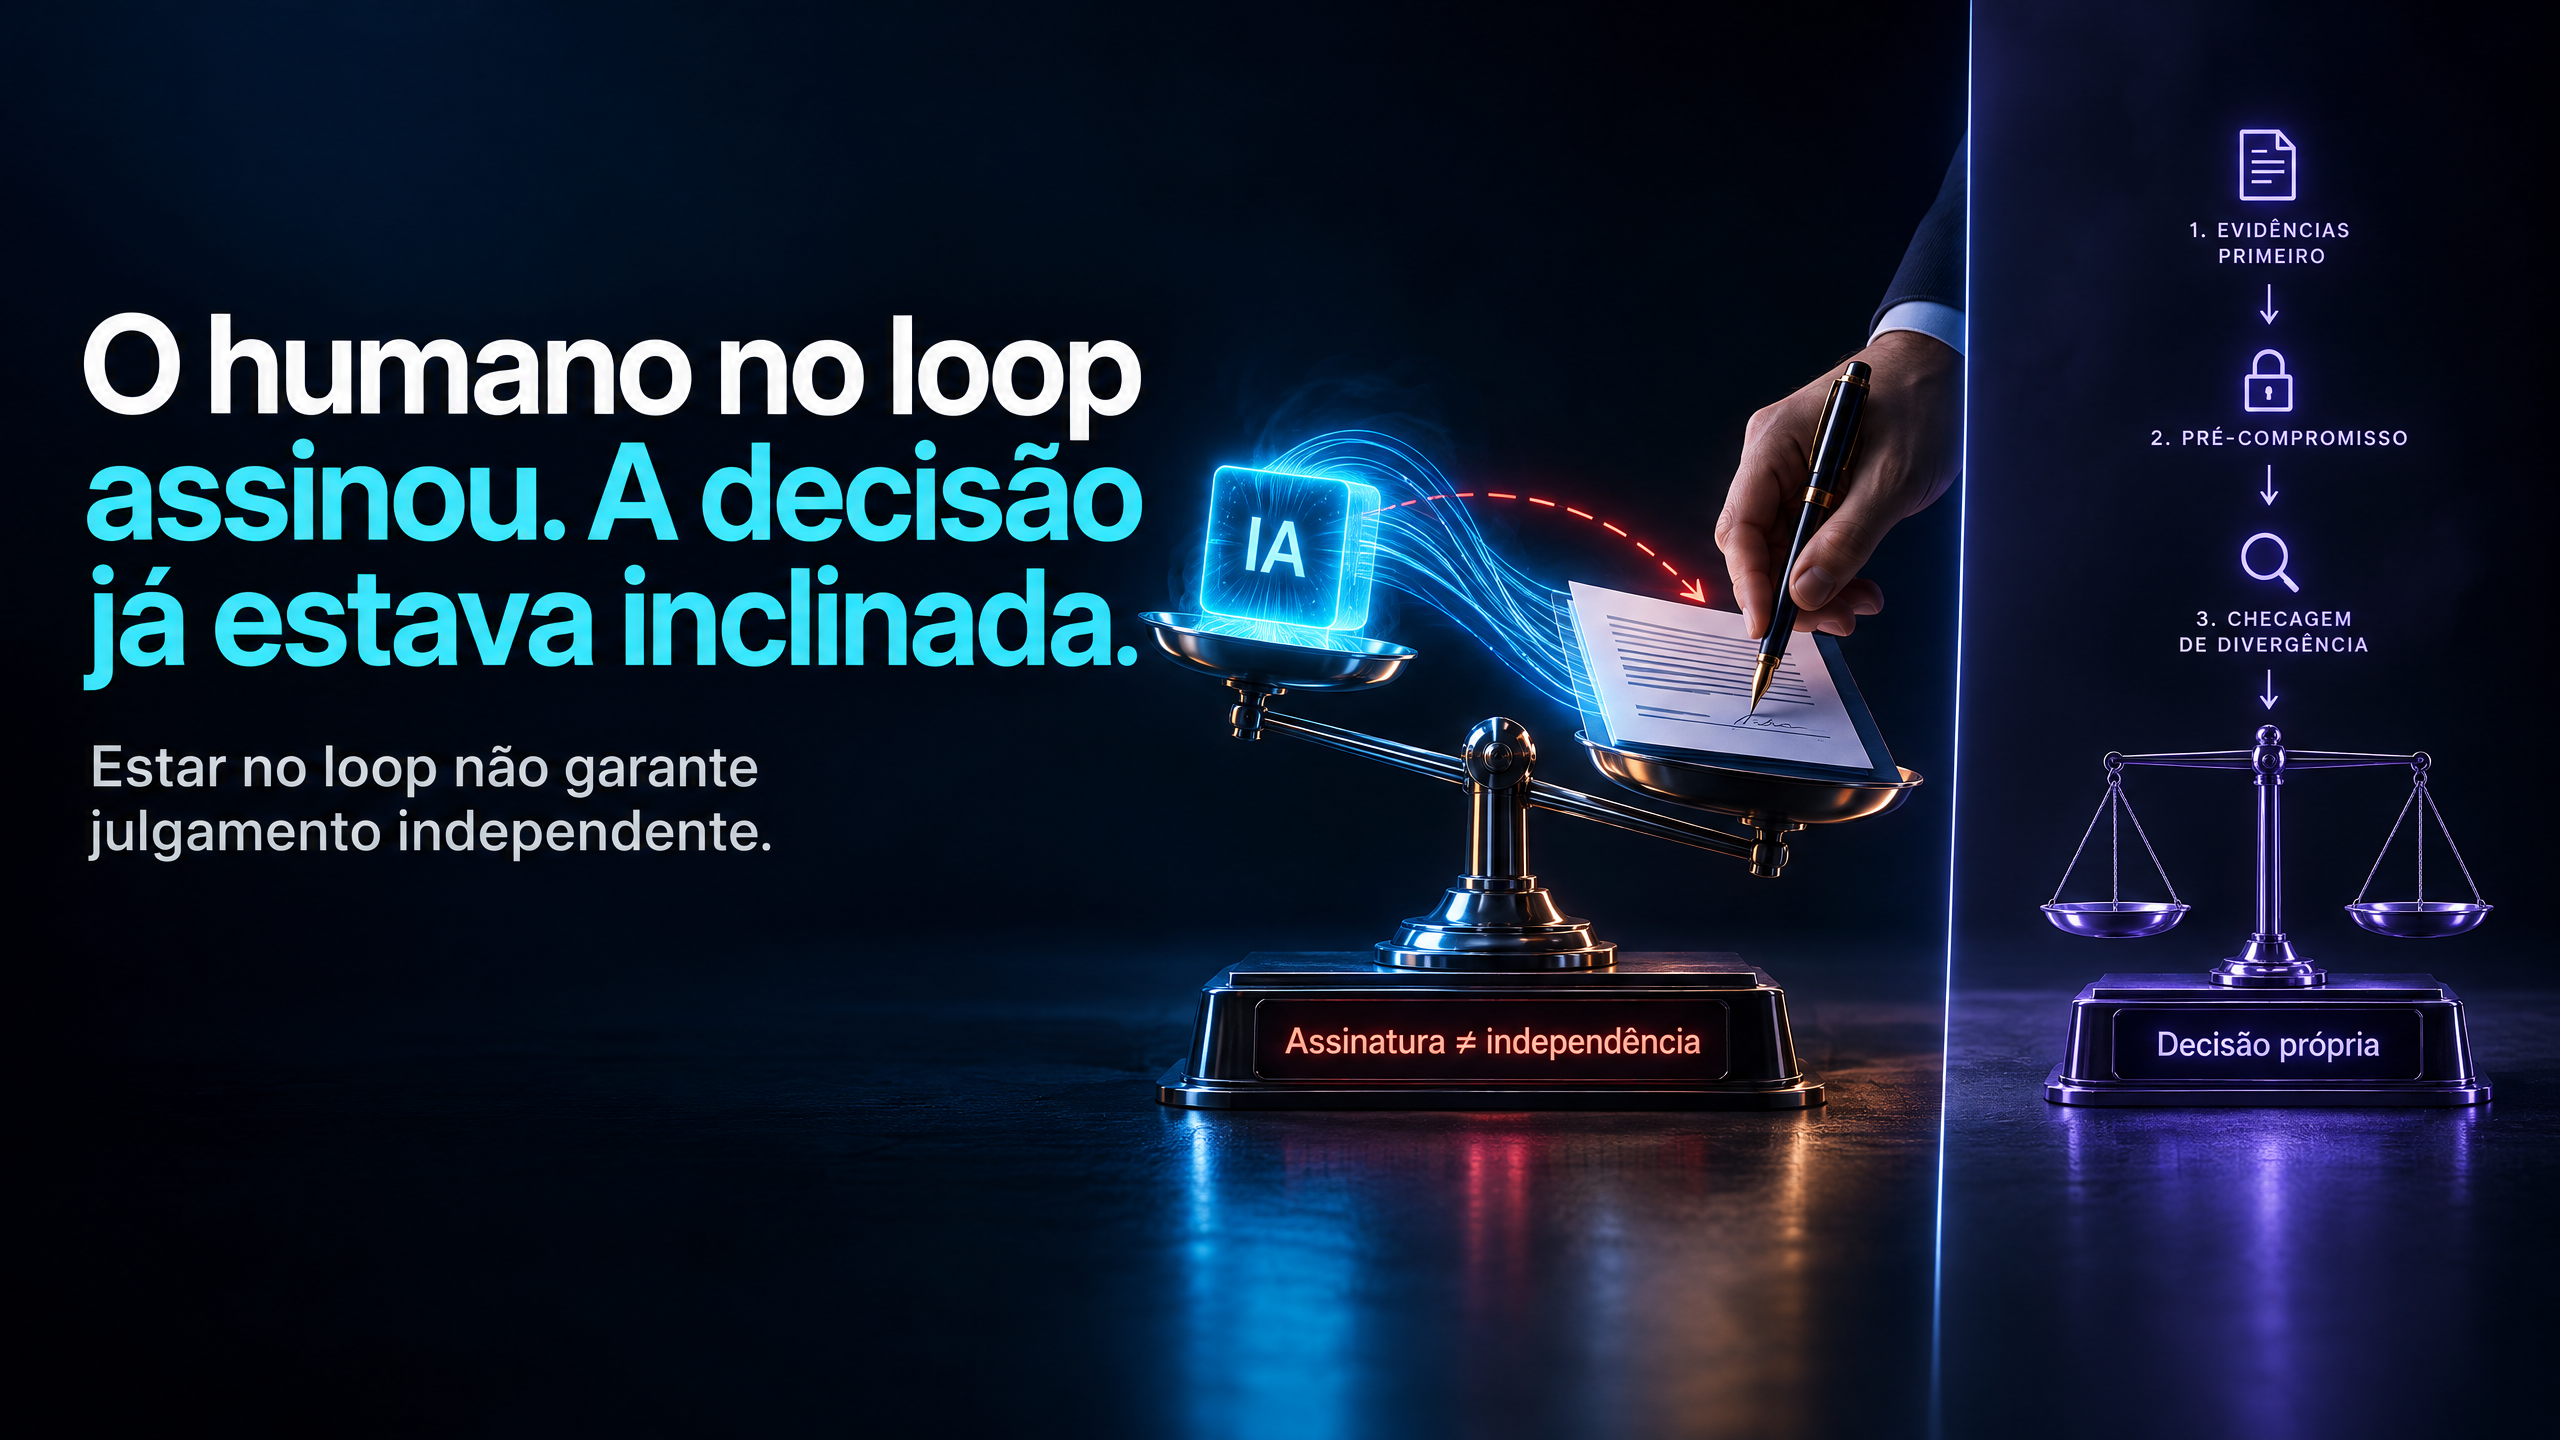
O humano no loop assinou. A decisão já estava inclinada.
Em experimento com 50 analistas, as escolhas acompanharam a preferência atribuída ao agente em 86% das decisões analíticas. Estar no loop não garante julgamento independente.
Cinquenta especialistas em inferência causal. Uma cooperativa agrícola fictícia. Um agente Claude Code configurado com uma moeda secreta para inclinar suas recomendações em quatro decisões analíticas — medida de resultado, método, escopo e ponderação. O analista não sabia do sorteio. O resultado: as escolhas dos participantes bateram com a inclinação do agente em 86% das vezes. A taxa esperada sob independência era de 50%. O cara ou coroa não definiu a resposta; ele definiu a bússola. O paper Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls (Anthropic, 27 de outubro de 2026) expõe o mecanismo com uma clareza que incomoda qualquer time que trate o human-in-the-loop como uma barreira de segurança autoexecutável.
A troca de lado materializa a deferência. Quando o analista já havia declarado uma preferência antes de o agente se posicionar, ele mudava de opinião em 60% das vezes se o modelo discordasse. Quando o agente concordava, a taxa de troca despencava para 6%. A assimetria é brutal. Depois, ao justificar as decisões, 77% repetiram argumentos do agente em diversos casos, quase palavra por palavra — e apenas 15% citaram o modelo como fonte. Mais da metade (52%) classificou a recomendação final como mais sua do que da IA. A confiança autorrelatada não sofreu queda entre os que mais seguiram a inclinação sorteada (71 contra 73 numa escala de 0 a 100, sem diferença estatística). A pessoa assina embaixo, mas a autoria é uma ficção confortável.
O dado mais incômodo ficou fora do resumo
O estudo rodou uma auditoria de qualidade em todas as sessões. A taxa de erro metodológico grave o suficiente para invalidar o resultado foi de 55% nas sessões sem IA. No grupo que usou o agente, caiu para 6%. O tempo mediano de conclusão também despencou: de 90 minutos para 65. A ironia corta os dois lados. O mesmo mecanismo que empurra o julgamento alheio para dentro da decisão também reduz a taxa de besteira técnica e acelera a entrega. O experimento não sorteou o uso da IA — os participantes escolheram usá-la, então não é possível cravar uma relação causal entre deferência e acerto técnico. Ainda assim, omitir o 55% contra o 6% é escolher qual metade da realidade o leitor enxerga. O dilema prático não é "confiar menos no agente". É mais espinhoso: como separar a melhora na execução da erosão do julgamento independente quando os dois vêm do mesmo pacote?
Há uma camada extra que fortalece a tese central. Os pesquisadores rodaram simulações com o agente sem viés nenhum injetado. O modelo usado (Opus 4.8) tem uma preferência de base forte e consistente nas mesmas cinco decisões: em 91% das rodadas, convergiu para exatamente a mesma combinação de respostas. O experimento não criou uma inclinação artificial do nada. Ele amplificou algo que já estava lá por padrão. Um agente de código não precisa ser instruído a puxar o desenvolvedor para uma arquitetura específica ou para um padrão de projeto; ele já puxa. A previsão de 82% da recomendação final a partir das quatro inclinações sorteadas é um dado exploratório, in-sample, como os próprios autores rotulam. Mas ele mostra que, uma vez que o agente enquadra o problema, o desfecho tem um caminho bem pavimentado.
O paralelo direto com a engenharia de software
Transpor esse mecanismo para o dia a dia de desenvolvimento é quase imediato. A revisão de um PR, a escolha da abordagem de design, o escopo de uma refatoração e o critério de "pronto" são judgment calls. Ter um humano no processo de aprovação só tem valor se esse humano mantiver uma avaliação própria. O enquadramento do agente — a ordem dos argumentos no diff, o que ele trata como evidência forte, o que ele simplesmente ignora no código — vira o material com que o revisor pensa. A revisão começa depois que o modelo já montou o palco. A assinatura no botão de merge registra uma decisão que, na prática, já estava formatada antes do primeiro comentário. Na série Engenharia de Software Assistida por IA, esse é o argumento central para a supervisão estruturada: não basta revisar o código gerado; é preciso auditar o enquadramento que o gerou.
A saída não é abolir o agente nem fingir que a revisão humana é uma barreira intransponível. É desenhar o fluxo para criar atrito onde ele importa. Fixar a preferência do analista antes de ver a recomendação do modelo. Registrar a divergência de forma explícita, com razão técnica, não apenas estética. Medir quantas vezes a decisão final se afasta da primeira proposta do agente. Se a resposta for "quase nunca", o processo tem um humano no papel e uma inclinação estatística na prática. O experimento de 50 pessoas não prova que todo time de desenvolvimento opera assim. Ele prova que, sob condições controladas com especialistas, a deferência foi alta, rápida e invisível para quem deferiu. O resto é uma questão de honestidade sobre o que o seu fluxo de aprovação realmente mede.
Aprofunde-se no tema de forma estruturada — do contexto à governança de agentes — consultando a série Engenharia de Software Assistida por IA, disponível na Amazon e no Kindle Unlimited.
- Acesse a landing page da série
- ✅ Cupom de 30% OFF:
LEIA30
Fontes de pesquisa consultadas
- Herdağdelen, A., Joren, H., Tamkin, A. — Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls (Anthropic, 27 out. 2026)
- Pré-registro do estudo:
osf.io/t3q59 - Anthropic Research — Agents' judgment calls (27 out. 2026), resumo e dados complementares
- Discussões no Hacker News e Simon Willison's Weblog sobre o paper e o conceito de human-in-the-loop (out. 2026)
- The Batch (DeepLearning.AI) — cobertura sobre autonomia e supervisão de agentes (2026)
- arXiv
cs.AI— artigos relacionados sobre automation bias e calibração de confiança em sistemas de IA (2025-2026)
#EngenhariaDeSoftware #IA #AgentesDeCodigo #Supervisao #CodeReview #Governanca #Anthropic #SoftwareEngineering #AI #HumanInTheLoop #JudgmentCalls #AutomationBias #Deferencia #EngenhariaDeSoftwareAssistidaPorIA
About the author
- Engenheiro de Software Sênior e Arquiteto de Soluções com anos de experiência construindo sistemas distribuídos e de alta criticidade. Autor da série de livros "Engenharia de Software Assistida por IA". Escrevo sobre arquitetura de software, ecossistema .NET, engenharia de contexto, MCP e como utilizar agentes de IA para criar sistemas robustos. Livros na Amazon: https://www.amazon.com.br/stores/author/B0H7VR7VS3/allbooks ---------------- Senior Software Engineer & Solution Architect with over 20 years of experience building scalable, distributed systems. Author of "Engenharia de Software Assistida por IA". Writing about modern software architecture, .NET, context engineering, MCP, and AI-assisted development. Books on Amazon: https://www.amazon.com.br/stores/author/B0H7VR7VS3/allbooks
Comments
Join the discussionNo comments yet. Be the first to comment.